
Как да съберем семантично ядро и какво да правим с него?
Семантичното ядро е фундаментът на всяка SEO стратегия – картата на темите, намеренията и въпросите, по които трябва да сме видими. Ето как го събираме, подреждаме и превръщаме в резултати.
Съдържанието е в основата на дигиталното присъствие, а неговият градивен материал са думите – по-точно заявките, които потребителите въвеждат в търсачките и в AI инструментите. За да привлечем правилната аудитория, страниците и съдържанието ни трябва да са релевантни на това, което хората реално търсят. Затова всеки SEO процес започва с едно нещо – събиране на семантично ядро.
Семантичното ядро е съвкупността от всички ключови думи, изрази, въпроси и теми, релевантни за продукта или услугата, която предлагаме. Събрани и подредени, те показват какво иска аудиторията и по какъв път стига до нас. В следващите редове ще преминем през понятията, инструментите и стъпките, с които изграждаме ефективно ядро – и през начините, по които то захранва цялата SEO стратегия.
Основни понятия
Няколко термина, около които се върти процесът на работа със семантика:
|
Понятие |
Какво означава |
|---|---|
|
Семантично ядро |
Съвкупността от всички ключови думи, изрази, въпроси и теми, релевантни за продукта или услугата – структурирани по намерение и тема. |
|
Клъстеризация |
Групиране на заявките, които се обслужват от една и съща страница. Групираме по намерение и по припокриване на резултатите в Google, а не само по обща кл. дума. |
|
Search intent (намерение) |
Целта зад заявката – информационна, комерсиална, транзакционна или навигационна. Определя вида страница, който трябва да създадем. |
Инструменти за събиране на семантика
За българския пазар работим основно със Serpstat, допълнен от Google Keyword Planner. Към тях добавяме собствените данни от Search Console.
|
Инструмент |
В какво е силен |
Надеждност на данните |
|---|---|---|
|
Serpstat |
Обеми, сходни заявки, въпроси, конкуренти, вградена клъстеризация, лесен експорт в таблица |
Висока за BG – основен източник |
|
Google Keyword Planner |
Синоними и месечни търсения; насочен към платена реклама |
Ограничена – широки диапазони; допълващ инструмент |
|
Google Search Console |
Реалните заявки, по които сайтът вече се показва и получава кликове |
Най-надеждни – собствени данни на проекта |
Правилото е следното – идеите могат да идват отвсякъде, но обемите и приоритетите се валидират с данни от Serpstat и Search Console. AI инструментите ускоряват работата, но не са източник на надеждни данни за обеми на търсене.
Как се събира семантично ядро – стъпка по стъпка
Работният процес има пет стъпки. Ще ги преминем за примера с онлайн магазин за спортни екипи.
Стъпка 1 – Отправни думи и теми
Започваме не от една дума, а от темите, които бизнесът покрива – „спортни екипи“, „анцузи“, „екипировка по спорт“, „екипи по марки“. Всяка тема е бъдещ клъстер и източник на заявки. За да съберем възможно най-много идеи на този етап, можем да си помогнем с някой AI инструмент като му подадем продуктите/услугите, които предлагаме, и той да ни генерира идеи за релевантни към бизнеса думи и фрази.
Стъпка 2 – Разширяване на списъка с думи
За всяка тема от Стъпка 1 събираме възможно най-широк набор от заявки. Работим с няколко източника, защото всеки покрива различна част от търсенето.
Serpstat
Платформата ни позволява да търсим по различни критерии, а също така да изтеглим резултатите в табличен вид, което ни улеснява след това при клъстеризацията.
Важно преди старт: при всяко проучване в Serpstat първо трябва да изберем правилната регионална база (за нас – България). Грешната база дава грешни думи, обеми и конкуренти.
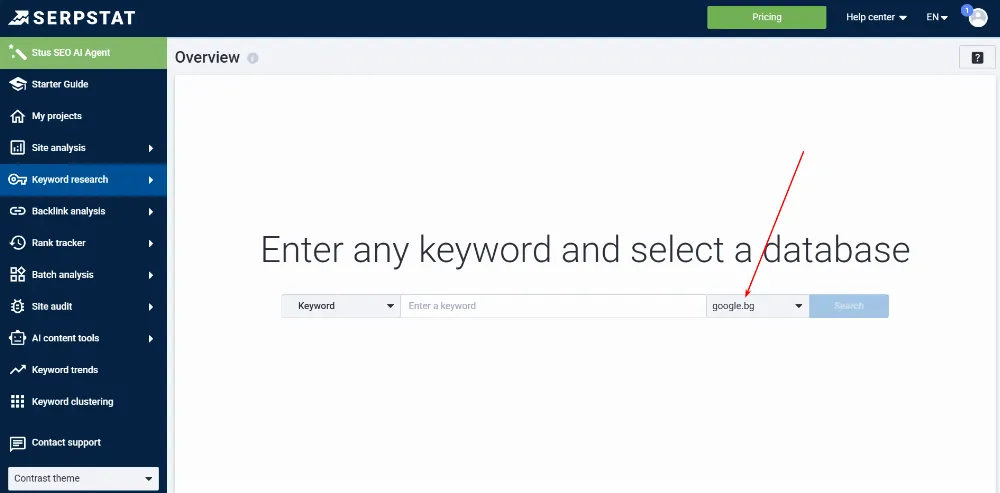
Започваме с отчетите в Keyword research инструмента. От там ще съберем основния списък с думи.
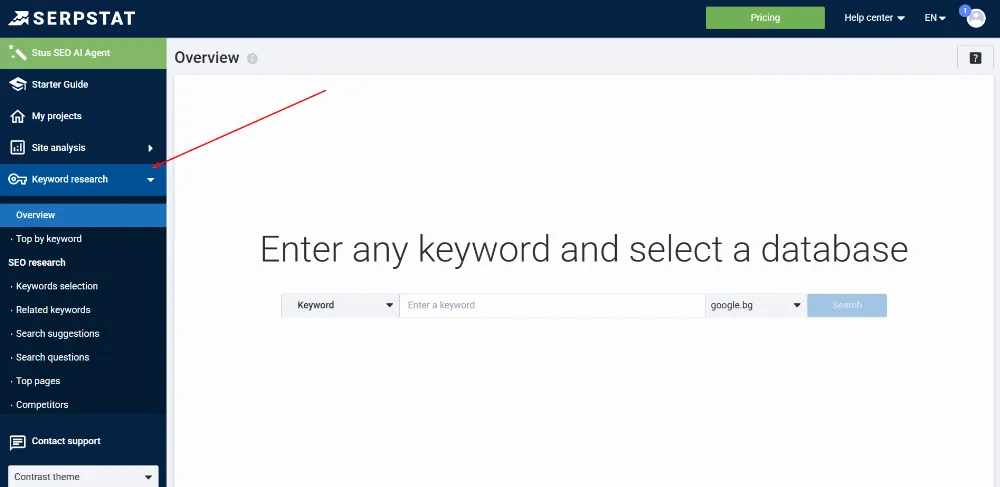
-
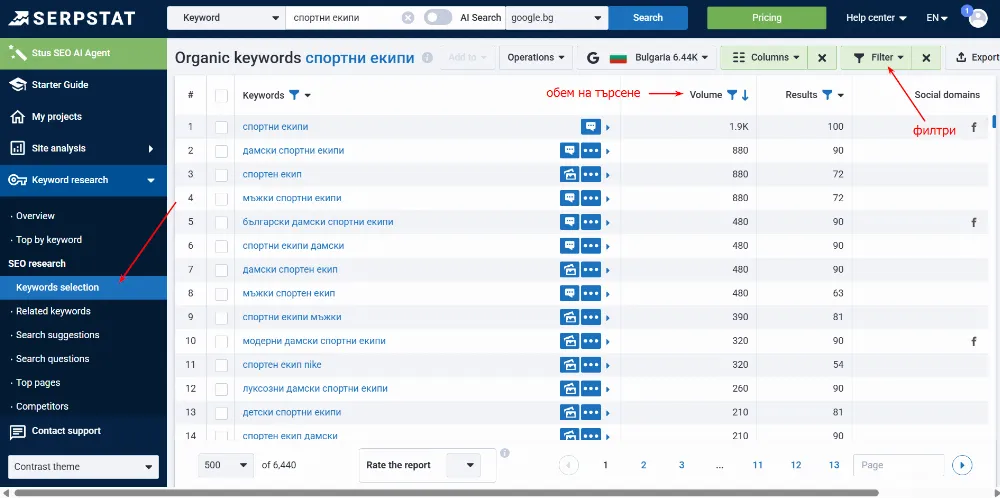
Keyword Selection – въвеждаме отправна дума (напр. „спортни екипи“) в Keyword Research → Keyword Selection. Serpstat връща всички заявки, които съдържат думата, заедно с обем на търсене. Можем да стесним списъка чрез филтрите:
-
диапазон на обема (напр. само 100–1000);
-
включващи/изключващи думи (напр. изключи „реплика“, „втора употреба“, ако продаваш само оригинални);
-
брой думи във фразата, ако търсиш конкретно long-tail.
-
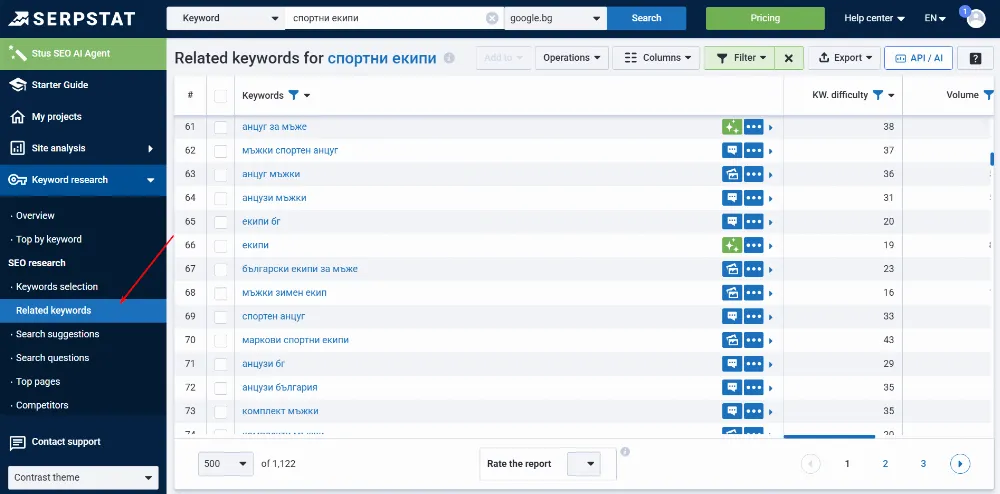
Related keywords – семантично свързани заявки, които невинаги съдържат самата дума (напр. „анцуг“ за „спортен екип“). Тук се хващат синоними и близки формулировки.
-
Search Suggestions – инструмент за проучване на ключови думи, който събира автоматично генерираните подсказки (autocomplete data) от търсачките в реално време.
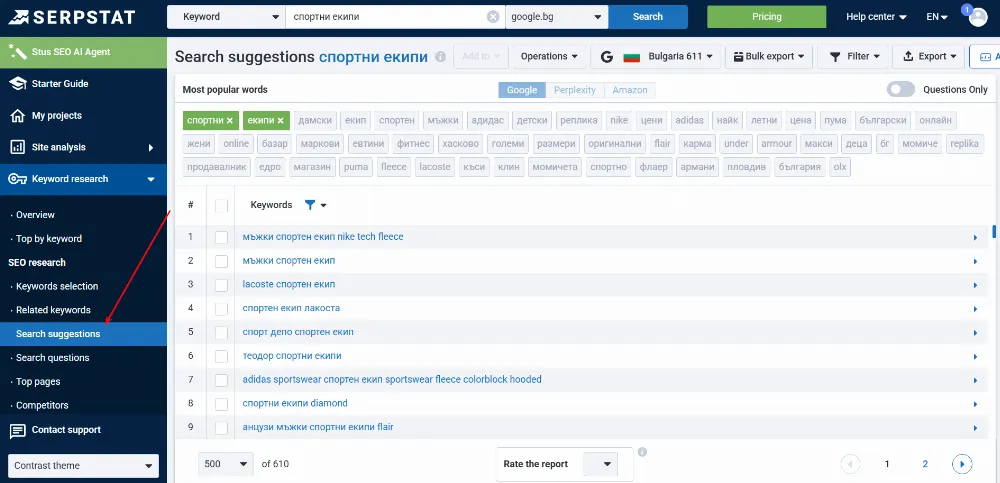
След като преминем през инструментите в Keyword Research, преминаваме към анализ на конкурентите.
-
В Site Analysis въвеждаме домейн на силен конкурент → отчет с думите, по които той се класира.
-
Сравнението на домейни в Keyword Gap (нашият срещу конкурент) показва заявки, по които конкурентите се класират, а ние – не. Получаваме готов списък с липсващи страници и теми.
-
Отчетът за органични конкуренти ни подсказва кои домейни изобщо да анализираме.
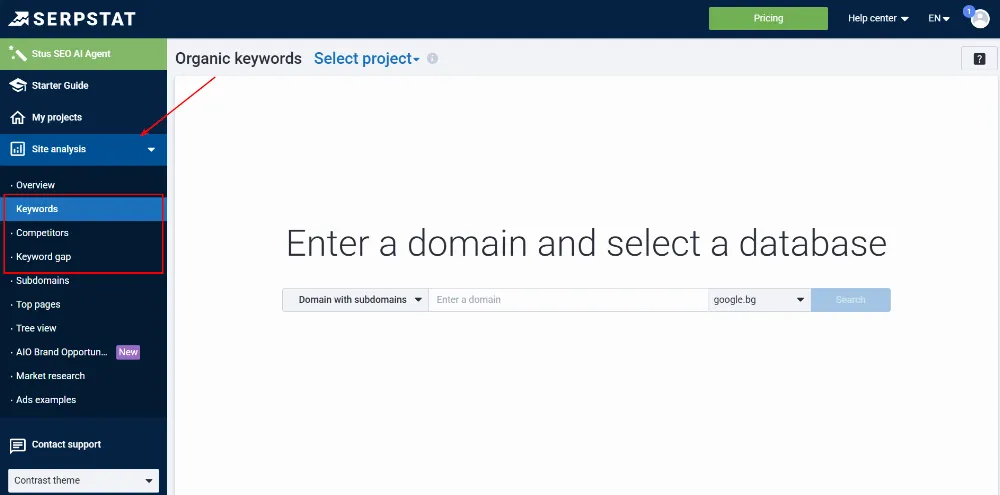
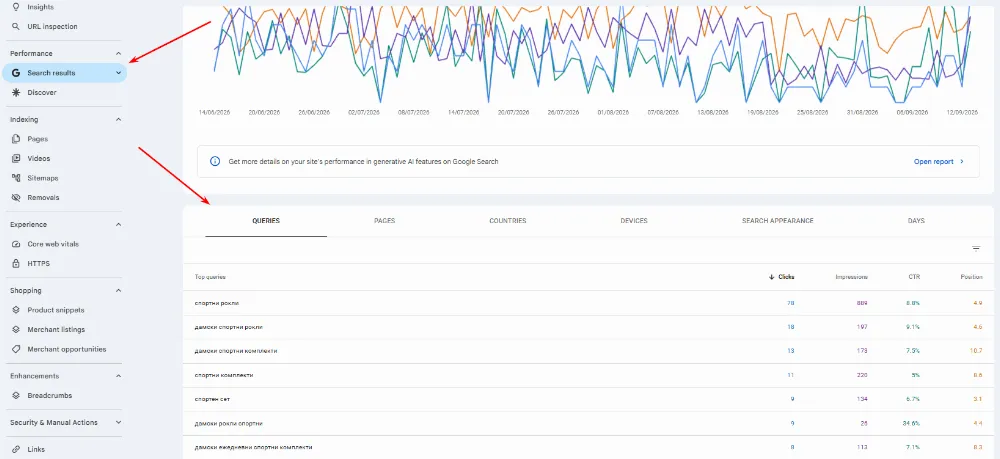
Google Search Console
Ако сайтът вече работи, GSC показва заявките, по които реално получаваме импресии и кликове – включително различни формулировки, long-tail заявки и разговорни фрази, които другите инструменти пропускат. Особено ценни са заявките, по които се позиционираме на страница 2 (позиции 11–20) – близо сме, но не влизаме в топ резултатите, което ги прави приоритетни за оптимизация.
Google Keyword Planner
Безплатен инструмент на Google Ads, полезен за синоними, идеи и месечни обеми. Стъпки:
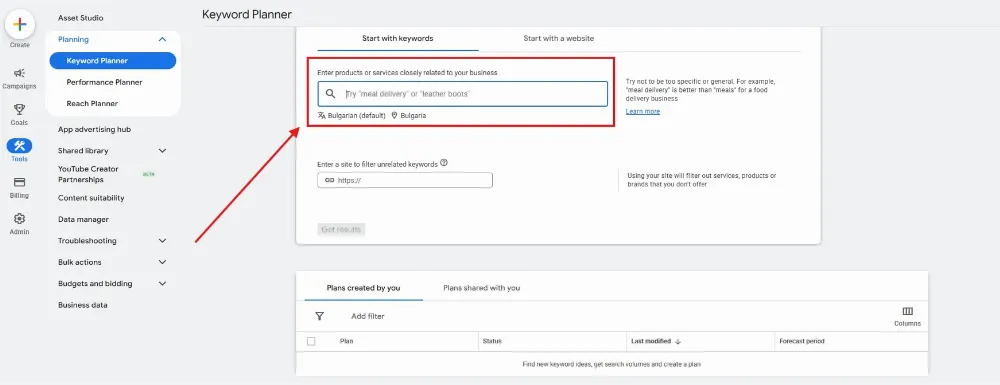
- Достъп – в Google Ads: Tools → Planning → Keyword Planner.
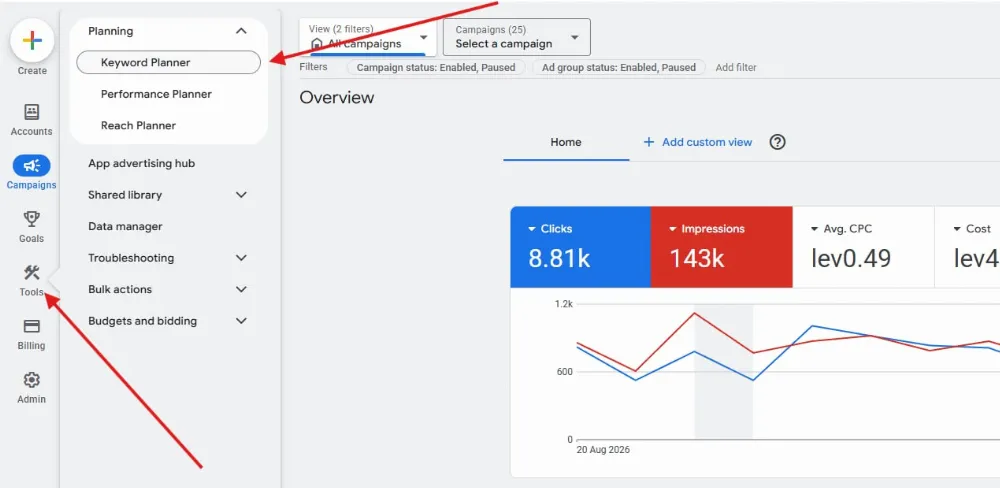
2. Избираме „Discover new keywords“ за нови идеи по отправна дума.
3. Въвеждаме дума – в таб „Start with keywords“ пишем кл. дума (напр. „спортни екипи“). Уверяваме се, че настройките за език и локация са коректни.
4. Преглеждаме резултатите – таблицата „Keyword ideas“ показва за всяка заявка: Avg. monthly searches (среден месечен обем), Three month change, YoY change, Competition и Top of page bid. Лентата „Broaden your search“ отгоре предлага разширяващи теми (облекло, спортен, дамско облекло…), а панелът „Refine keywords“ вдясно филтрира по атрибути (Brand/Non-Brand, пол и др.).
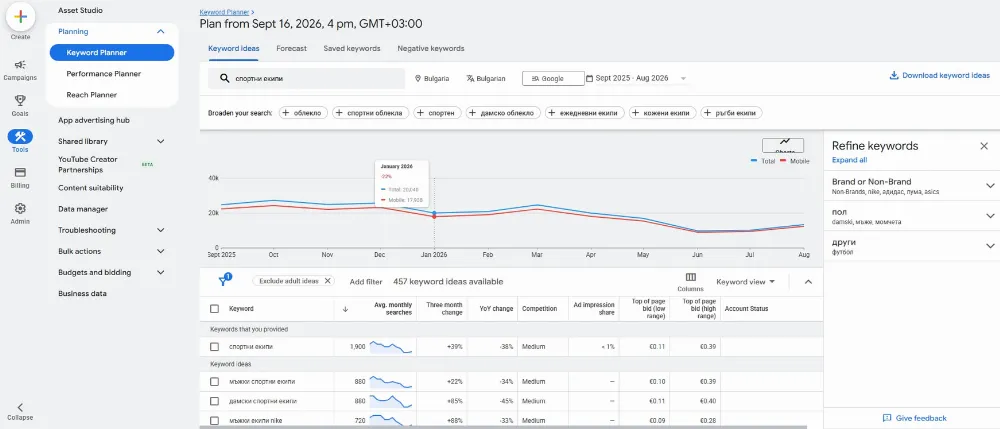
5. Филтрираме и правим подбор – с „Add filter“ и функционалностите в десния панел можем да изключим нерелевантните думи.
6. Сваляме списъка – „Download keyword ideas“ експортира в таблица, която добавяме към общото ядро.
Стъпка 3 – Почистване на списъка
Обединяваме всички списъци в две колони в Google Sheets – заявка и честота на търсене – и премахваме повторенията. Помните ли статията
-
Събираме подбраните списъци с думи в 2 колони - в колона 1 слагаме ключовите думи, а в колона 2 - честотата им на търсене.
-
За да премахнем повторенията, в съседната колона прилагаме функцията UNIQUE, като в зададения диапазон трябва да влизат всички думи от колона 1.
-
Копираме колоната с уникални стойности и я местим в отделен таб.
-
Използваме функцията VLOOKUP, за да добавим честотата на търсене на всяка ключова дума.
Тук отсяваме и нерелевантното – ако продаваме само оригинални стоки, заявки като „спортни екипи реплика“ или „втора употреба“ отпадат.
Прочетете още:
Стъпка 4 – Клъстеризация
Групираме заявките, които се обслужват от една и съща страница. Взимаме предвид два критерия:
-
Семантично / по намерение – „дамски екипи“ и „екипи за жени“ са едно намерение → един клъстер и една страница.
-
По припокриване на резултатите (SERP overlap) – ако Google показва почти същите резултати за две заявки, те стават за една страница. Ако резултатите се различават, ги разделяме.
Пример – „дамски екипи“ и „дамски екипи Adidas“ изглеждат близки, но Google ги обслужва различно: първата е за категория „Дамски екипи“, втората – за категория с филтър по марка Adidas. Значи два клъстера, две страници.
Самото групиране може да стане по няколко начина. Изборът зависи от размера на ядрото и наличните ресурси.
Метод 1 – Ръчно
Разпределяме заявките на групи директно в таблицата, като вземем предвид намерението и целевата страница за всяка.
-
Предимство – не изисква никакви инструменти и дава пълен контрол върху клъстерите.
-
Недостатък – времеемко е. При ядро от няколко хиляди заявки отнема часове и рискът от грешки и пропуски е висок.
Метод 2 – Клъстеризация със Serpstat
Serpstat има собствен инструмент за клъстеризация, вграден в платформата.
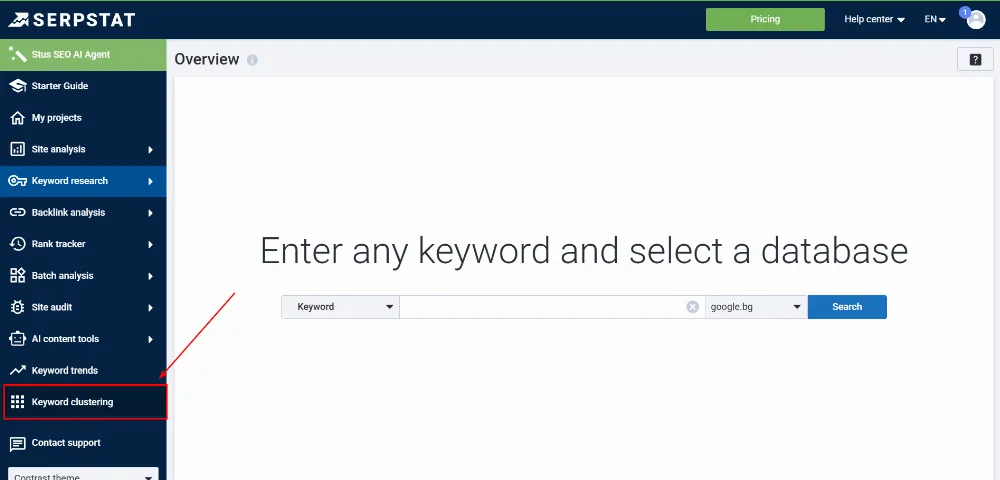
Качваме списъка със заявки (обработва до около 50 000 наведнъж), задаваме регионалната база (за нас България) и стартираме. Инструментът групира заявките по припокриване на резултатите в Google (SERP overlap).
Има два режима:
-
Hard – изисква всички заявки в групата да са свързани помежду си. Дава по-конкретни и по-малки клъстери.
-
Soft – по-невзискателен, събира по-големи групи. Задаваме и Strength (брой общи URL адреси), за да контролираме колко строги да са клъстерите.
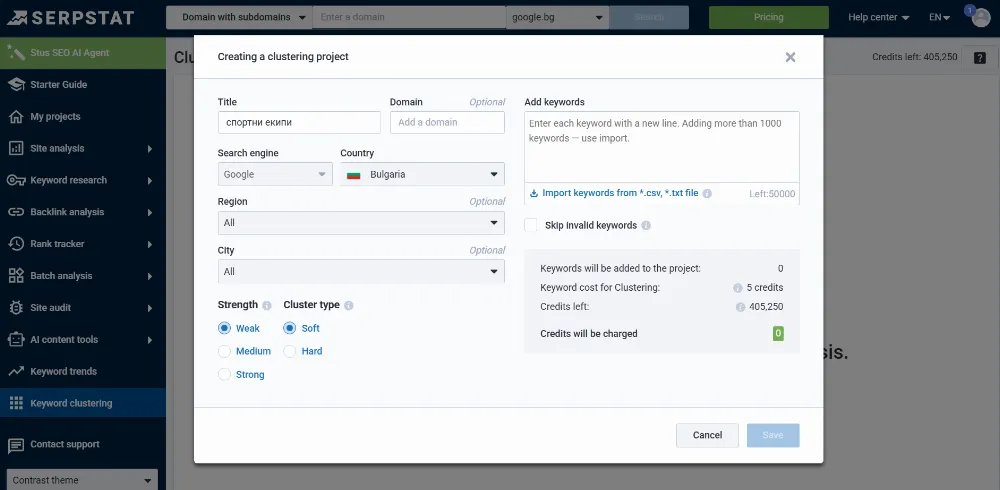
Методът е подходящ, когато броят на думи в семантичното ядро е голям и искаме бърз резултат по реални SERP данни, почти без ръчна работа. Финална човешка проверка пак е нужна, но започваме от много добра основа.
Метод 3 – Автоматизирано клъстериране
За по-големи семантични ядра можем да използваме и готова Google Sheets таблица със скрипт, споделена в статията ни „
Метод 4 – Със собствен скрипт
За много големи или сложни ядра клъстеризацията може да се автоматизира и програмно – например с Python скрипт, който използва embeddings и групира заявките по семантична близост чрез съвременни алгоритми. Този подход дава най-голяма гъвкавост и контрол при огромни обеми.
Стъпка 5 – Приоритизация
Не всичко се прави наведнъж. Подреждаме клъстерите по комбинация от:
-
Обем на търсене и бизнес стойност;
-
Конкурентност и реалистичен шанс за класиране;
-
Съществуващи позиции по данни от Search Console;
-
GEO/AEO потенциал – информационни заявки, по които можем да сме цитираният отговор.
Как да използваме семантичното ядро
Готовото, клъстеризирано и приоритизирано ядро захранва цялата SEO работа:
-
Структура на сайта – клъстерите показват какви категории, подкатегории и филтри трябва да имаме на сайта.
-
Съдържание – всеки клъстер става страница или статия, която покрива темата (с подтеми, въпроси, синоними). Целта е полезно съдържание по стандарта на Google за helpful content.
Важно: и при изграждането на структурата, и при създаване на съдържанието, е важно да разберем намерението (search intent) зад заявките.
Една и съща тема ражда заявки с различна цел, а всяка цел иска различен тип страница. Ако за комерсиална заявка създадем информационна страница (или обратното), няма да се класираме – независимо колко добро е съдържанието ни.
Четирите основни типа намерение са:
|
Намерение |
Пример заявка |
Подходяща страница |
|---|---|---|
|
Информационно |
„как да изберем спортен екип“ |
Блог статия, ръководство, FAQ |
|
Комерсиално (проучване) |
„най-добри спортни екипи 2026“ |
Сравнение, категория с обзор, топ листи |
|
Транзакционно |
„дамски спортен екип Adidas цена“ |
Продуктова или категорийна страница |
|
Навигационно |
„спортни екипи магазин“ |
Начална или бранд страница |
Преди да използваме семантичното ядро, е добре да маркираме заявките с намерение (информационно / комерсиално / транзакционно / навигационно). Това предопределя вида страница, която трябва да създадем, и не позволява да смесим заявки, с които потребителите имат различни цели.
-
Метаданни – високочестотните думи ще използваме за съставянето на Meta Title, Meta Description и H1 на страниците.
-
Вътрешно налинкване – ключовите думи можем да използваме като анкорни връзки за вътрешно налинкване между свързани страници на сайта. Важно е да не гоним exact match на заявката, а да са релевантни в съдържанието и да звучат "човешки". Например ако имаме “спортни екипи цени” трябва да го преобразуваме на “Цени на спортни екипи”.
-
FAQ и AI отговори – въпросителните заявки включваме във FAQ секции, оптимизирани за AI Overviews и AI инструменти.
 27
 11
 0
 16
 0
Препоръчани нови статии
Как да разпишем и оптимизираме метаданните Title, Description и H1
Нека видим какво е най-важно, когато става дума за оптимизация на съдържанието в нашия сайт.
Създаване на SEO текстове в ерата на AI – как да пишем съдържание за хора и генеративни търсачки?
Cloudflare: препоръки за SEO, AI търсене (GEO), AI асистиране (AEO) и скорост