
1. Какво представлява SEF URL адресът
1.1 За термина
SEF (Search Engine Friendly) URL е адрес, изграден логично и разбираем за човек. Среща се и като clean URL, pretty URL, user-friendly URL, а в рускоезичната и в нашата практика – като ЧПУ.
Първата подробност си заслужава да се спомене: търсачките не използват този термин. В документацията на Google няма „SEF". Google пише за URL структура, описателни адреси, slug и permalink.[1][2] Терминът идва от средите на системите за управление на съдържание, където обозначава пренаписването на адреси от вида index.php?option=com_content&id=42 в четим път.
Това има практическо значение. Ако търсите официално потвърждение за „SEF практики", няма да го намерите под това име. То е разпръснато из десетина документа, които тази статия събира на едно място.
1.2 От какво се състои адресът
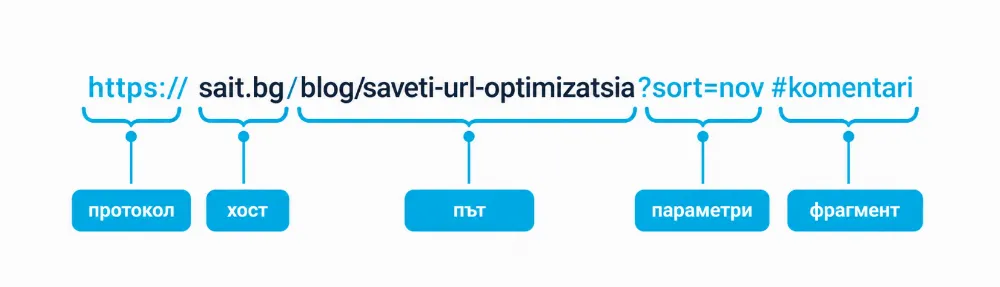
| Протокол | https:// или http:// |
| Хост | поддомейнът, домейнът и домейнът от първо ниво заедно |
| Път | йерархията от сегменти, разделени с наклонена черта |
| Параметри | низът след въпросителния знак |
| Фрагмент | всичко след диеза |
1.3 Едно определение, което ще ни трябва по-нататък
За инфраструктурата за обхождане на Google „сайт" означава уникален хост. https://www.example.com/ и https://code.example.com/ са два отделни сайта с два отделни бюджета за обхождане.[5]
Ще се върнем към това два пъти – при поддомейните и при многоезичните сайтове.
2. Кое Google изисква и кое препоръчва
Тази разлика редкo се прави в българските материали, а е основната. Документацията за URL структура е разделена на две отделни таблици – изисквания и добри практики.[1]
Ако адресите не покриват изискванията, Google предупреждава, че вероятно ще обхожда сайта неефективно, включително с прекомерно висока честота на обхождане или изобщо няма да го обхожда.[1]
2.1 Трите изисквания
Съответствие с IETF STD 66. Google поддържа адресите така, както ги дефинира стандартът. Символите, които стандартът определя като резервирани, задължително се кодират процентно.[1]
Без фрагменти за смяна на съдържанието. Google по принцип не поддържа фрагменти в адреса. Адрес от вида https://example.com/#/potatoes създава проблем. Когато съдържанието се сменя чрез JavaScript, решението е History API.[1][17]
Стандартно кодиране на параметрите. Знак за равенство между ключа и стойността, амперсанд между отделните параметри. За няколко стойности на един ключ – символ, който не влиза в конфликт със стандарта, например запетая.[1]
Google дава изричен пример какво не приема:
|
Препоръчително |
Непрепоръчително |
|---|---|
|
?category=dresses&sort=low-to-high&sid=789 |
?[category:dresses][sort:price-low-to-high][sid:789] |
|
?category=dresses&color=purple,pink,salmon |
?category,dresses,,sort,lowtohigh,,sid,789 |
Ако филтрите на магазина ви генерират адреси от втората колона, това не е въпрос на естетика, а неизпълнено изискване.
2.2 Седемте препоръки
-
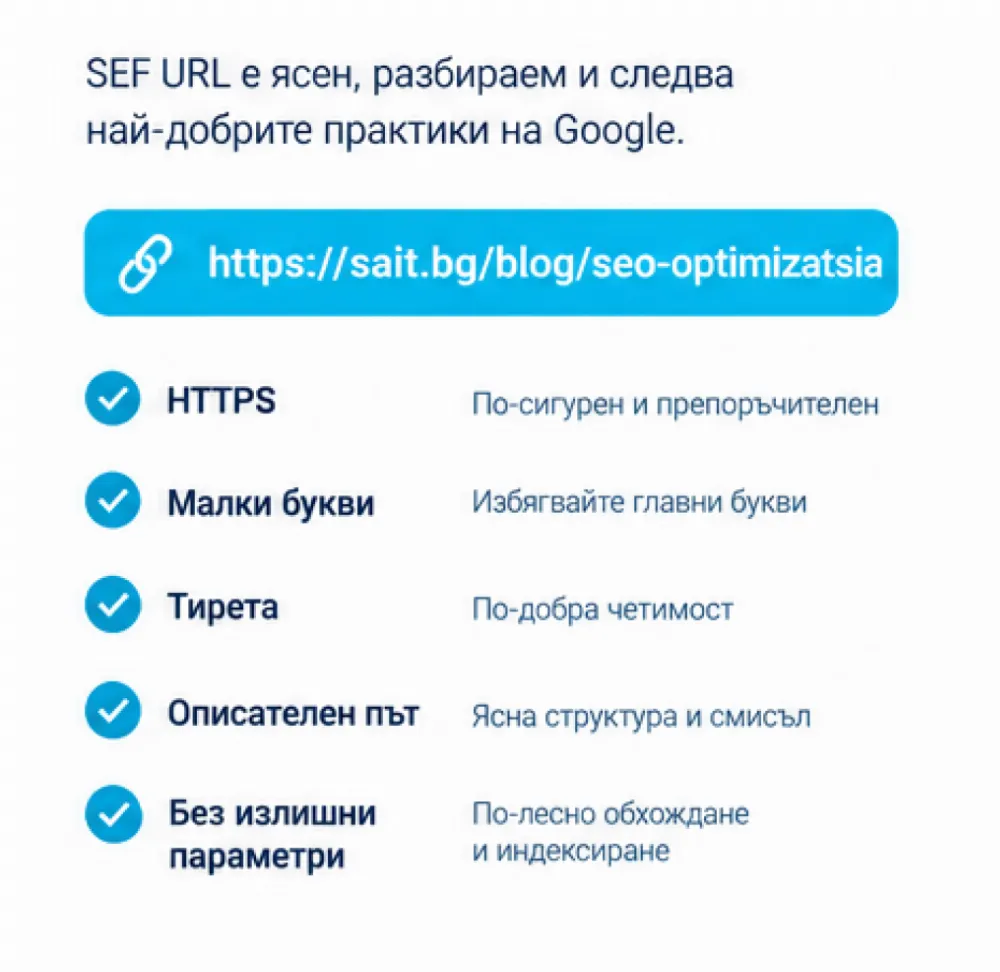
Описателни думи вместо дълги идентификатори. example.com/wiki/Aviation вместо example.com/index.php?topic=42&area=3a5ebc944f41daa6f849f730f1[1]
-
Езикът на аудиторията в адреса, „и ако е приложимо, транслитерирани думи"[1]
-
Процентно кодиране в атрибутите href, където се налага[1]
-
Тирета вместо долни черти[1]
-
Възможно най-малко параметри. Тези, които не променят съдържанието, отпадат[1]
-
Съобразяване с това, че адресите са чувствителни към регистъра[1]
-
Структура, която улеснява геотаргетирането при многорегионални сайтове[1]
2.3 Тиретата: формулировката на Google е по-полезна от обичайната
Обичайното обяснение е, че тирето се чете като интервал, а долната черта – не. Google го формулира по-конкретно:
По исторически причини не препоръчваме долни черти, защото този стил вече се използва широко за обозначаване на понятия, които трябва да останат заедно – например при именуването на функции в програмните езици, като format_date.[1]
Стилистичното ръководство на Google за техническа документация казва същото за имената на файлове и папки.[18]
Още през 2007 г. Matt Cutts, тогава ръководител на екипа Webspam в Google, добави важното уточнение: ако сайтът работи с долни черти, преправянето им не си заслужава. Тиретата са изборът за нови адреси.[19]
Практически извод: aко имате ресурс за едно нещо, покрийте изискванията. Препоръките надграждат, но не заместват основата.
3. Пет неща, за които Google казва, че нямат значение
Тази глава е за задачи, които спокойно могат да отпаднат от списъка.
Google поддържа страница „Митове и факти за обхождането", на която сам поставя разпространени твърдения и им отговаря.[3]
|
Разпространено твърдение |
Отговорът на източника |
|---|---|
|
Google предпочита чисти адреси и не харесва параметри |
Невярно. Параметрите се обхождат[3] |
|
По-късите адреси се класират по-добре |
Дължината няма значение. Адресите служат като идентификатори[4] |
|
Повече наклонени черти вредят на класирането |
Броят наклонени черти не влияе на класирането[4] |
|
По-честото обхождане води до по-добро класиране |
Невярно. Обхождането е необходимо, но не е сигнал за класиране[3] |
|
Ключовата дума в адреса е сериозен фактор |
Ключовите думи в домейна или в пътя почти нямат ефект извън появата им в навигационната пътека[2] |
3.1 Защо тогава проучванията откриват по-къси адреси в челните позиции
Отговорът е публичен, но рядко се цитира.
В епизод на #AskGooglebot John Mueller от Google отговаря директно: дължината няма значение, защото адресите служат като идентификатори. Лично той държи адресите под 1 000 знака, но заради удобството при наблюдение, не заради SEO.[4]
След това идва уточнението, което обяснява всичко:
Единствената част от системите ни, в която дължината на адреса играе роля, е канонизацията. Когато открием няколко копия на една страница и трябва да изберем един адрес за индексиране, при по-кратък и по-ясен адрес системите ни са склонни да изберат него.[4]
Това не влияе на класирането. Влияе на въпроса кой от няколко дублирани адреса ще се покаже.[4]
Ето и механизмът зад корелацията. Големите сайтове с натрупан авторитет имат кратки адреси на важните си категорийни страници. Дългите адреси обикновено принадлежат на дълбоко разположено съдържание с по-малко връзки към него. Корелацията е реална. Причината обаче е другаде.
3.2 Дълбочината на папките не е дълбочина на кликовете
Двете лесно се смесват, а разликата има значение.
Google ги разделя изрично. На твърдението „колкото по-близо е съдържанието до началната страница, толкова по-важно е за Google" отговорът е отчасти вярно:
Началната страница често е най-важната на сайта, затова страниците, свързани директно с нея, може да се възприемат като по-важни и да се обхождат по-често. Това обаче не означава, че ще се класират по-високо от останалите страници на сайта.[3]
Тоест броят кликове от началната страница влияе върху честотата на обхождане. Броят наклонени черти в адреса не влияе върху нищо.[3][4]
3.3 Още пет уточнения от същия източник
-
noindex не пести бюджет за обхождане. Google трябва да свали страницата, за да види правилото[3][5]
-
crawl-delay в robots.txt не се обработва от Google[3]
-
Страниците със статус 4xx, с изключение на 429, не изразходват бюджет за обхождане[3]
-
Компресираните карти на сайта не увеличават бюджета за обхождане[3]
-
Алтернативните адреси (hreflang, AMP), CSS, JavaScript и заявките XHR изразходват бюджет за обхождане[3]
4. Адресът като идентификатор: дубликати и канонизация
Ако имате време за една глава, нека е тази. Почти всички реални проблеми с адресите се свеждат до един въпрос – колко адреса водят до едно и също съдържание.
4.1 Всяка разлика в изписването създава нов документ
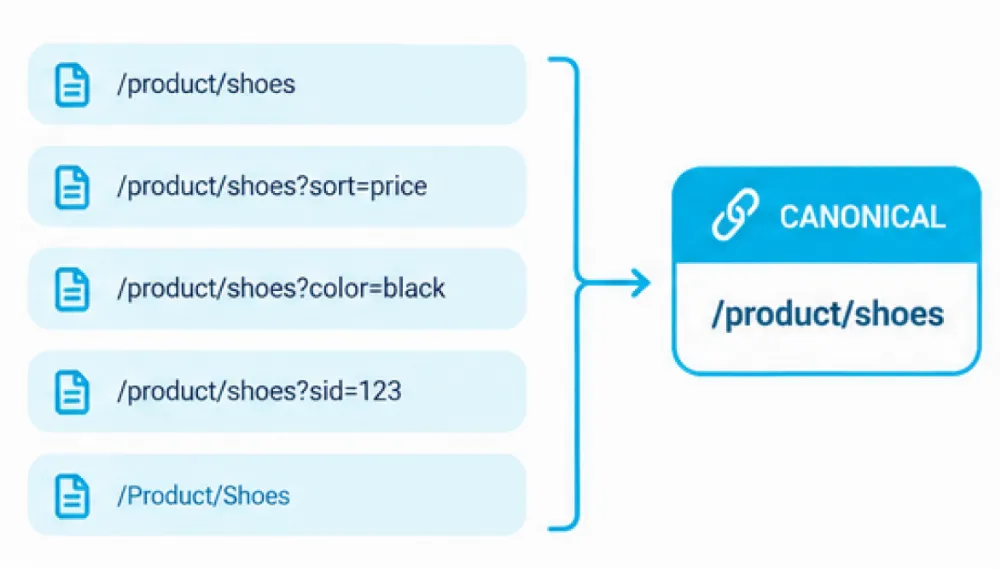
Канонизацията е процесът, при който търсачката избира представителен адрес за дадено съдържание. Google изброява типичните причини за дубликати: регионални варианти, версии за различни устройства, варианти по протокол, функциите за сортиране и филтриране, както и случайни варианти – например забравена тестова среда, достъпна за роботите.[13]
Bing допълва техническия списък: параметри в адреса, версии по HTTP и HTTPS, главни и малки букви, наклонена черта в края, версии за печат, публично достъпни тестови или архивни страници.[10]
4.2 Регистърът: широко разпространено схващане, което не се потвърждава
Често се твърди, че днес почти всички сървъри третират главните и малките букви еднакво.
Документацията на Google казва друго, при това недвусмислено:
Като всеки друг HTTP клиент, който следва IETF STD 66, обработката на адреси в Google Search е чувствителна към регистъра. Например Google третира /APPLE и /apple като различни адреси със собствено съдържание.[1]
Следва и препоръката:
Ако вашият сървър третира двете еднакво, приведете целия текст към един регистър, за да е по-лесно на Google да разбере, че адресите сочат към една и съща страница.[1]
На практика: изберете малки букви и наложете правилото на ниво сървър.
4.3 Как се избира каноничният адрес
Google подрежда методите по сила на въздействие в самата документация.[14] Две подробности изненадват.
Нито един метод не е задължителен. Дословно: сайтът най-вероятно ще се справи и без посочен каноничен адрес, защото ако не го направите, Google ще прецени коя версия е обективно най-подходяща за показване.[14]
Методите се допълват. Използването на два или повече увеличава шанса предпочитаният от вас адрес да се появи в резултатите.[14]
Каноничната страница се обхожда най-редовно. Дубликатите се обхождат по-рядко, за да се намали натоварването върху сайта.[13]
4.4 Дублираното съдържание не се наказва
Google, в SEO Starter Guide, под заглавието „Неща, върху които според нас не си струва да се фокусирате":
Ако имате съдържание, достъпно на няколко адреса, това е нормално и няма за какво да се притеснявате. Неефективно е, но не води до ръчна санкция.[2]
Bing описва същото по-подробно: дублиращите се адреси сами по себе си не вредят на сайта, но размиват информацията, с която търсачките разбират съдържанието и оценяват релевантността. Сигналите – кликове, връзки, импресии, ангажираност – се разпределят между няколко адреса, вместо да усилят един.[10]
4.5 Един инструмент на Bing, за който рядко се говори
Bing предлага URL Normalization в Bing Webmaster Tools – правила за нормализация, които се задават директно в инструмента, без промени по кода. Логиката е, че роботът продължава да посещава каноничните източници, за да провери дали целта не се е сменила, и така изразходва ресурс. Правилата за нормализация решават въпроса по-рано в процеса.[28]
Полезно, когато екипът за разработка няма капацитет да въведе канонични тагове веднага.
4.6 Класическият случай: продукт в две категории
Два различни адреса с идентично съдържание. Решенията са три:
-
Продуктите извън категорийната йерархия – /product-1. Google препоръчва точно това при варианти на продукти: за каноничен се използва адресът без параметри[23]
-
Каноничен таг от вложените версии към основната
-
Последователност във вътрешните връзки, за да сочат всички към каноничния адрес
Третото се пропуска най-често, а има най-голямо значение.
5. Параметри, филтри и бюджет за обхождане
5.1 Първо: отнася ли се темата до вашия сайт
Google дава конкретни ориентири за кои сайтове бюджетът за обхождане (crawl budget) има смисъл:[5]
-
Големи сайтове с над 1 милион уникални страници, чието съдържание се променя умерено често, около веднъж седмично
-
Средни и по-големи сайтове с над 10 000 уникални страници с ежедневно променящо се съдържание
-
Сайтове, при които голяма част от адресите попадат в Search Console в категорията „Discovered – currently not indexed"
Google уточнява, че числата са груб ориентир, а не точни прагове.[5] И добавя изречението, което спестява доста излишна работа:
Ако сайтът ви няма голям брой бързо променящи се страници или ако страниците изглежда се обхождат в деня на публикуване, това ръководство не ви е нужно.[5]
За блог с 200 страници темата е обща култура, а не приоритет.
5.2 Как работи
Бюджетът за обхождане се формира от две неща.[5]
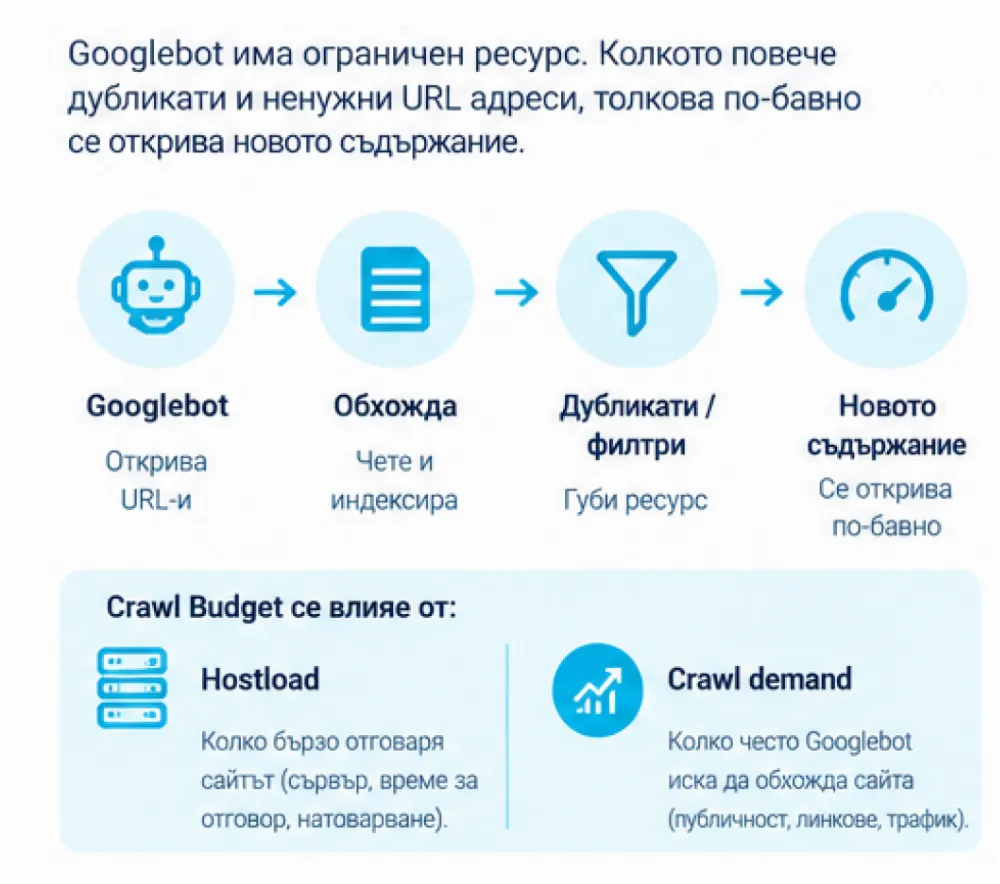
Лимит на капацитета за обхождане, наричан и hostload. Той ограничава общото време, в което сървърът ви държи връзки отворени за Google. Всеки сайт започва с еднакъв консервативен лимит. При стабилни отговори и добри времена лимитът се вдига. При забавяне, при грешки 5xx или при сигнали за ограничаване като 429 лимитът пада.[5]
Потребност от обхождане. Зависи от размера на сайта, честотата на обновяване, качеството и релевантността спрямо други сайтове. Факторът, върху който имате най-голямо влияние, Google нарича perceived inventory: без насока от вас Google се опитва да обходи всички адреси, за които знае. Ако много от тях са дубликати или ненужни страници, това изразходва време.[5]
Двете заедно дават определението: бюджетът за обхождане е наборът от адреси, които Google може и иска да обходи.[5][16]
Едно важно допълнение: лимитът на капацитета е споделен между всички роботи на Google. По-високата потребност на един бот намалява капацитета за останалите.[5]
5.3 Филтърна навигация
Филтрите в онлайн магазините са най-честият източник на проблеми с обхождането. Google има отделен документ по темата.[9]
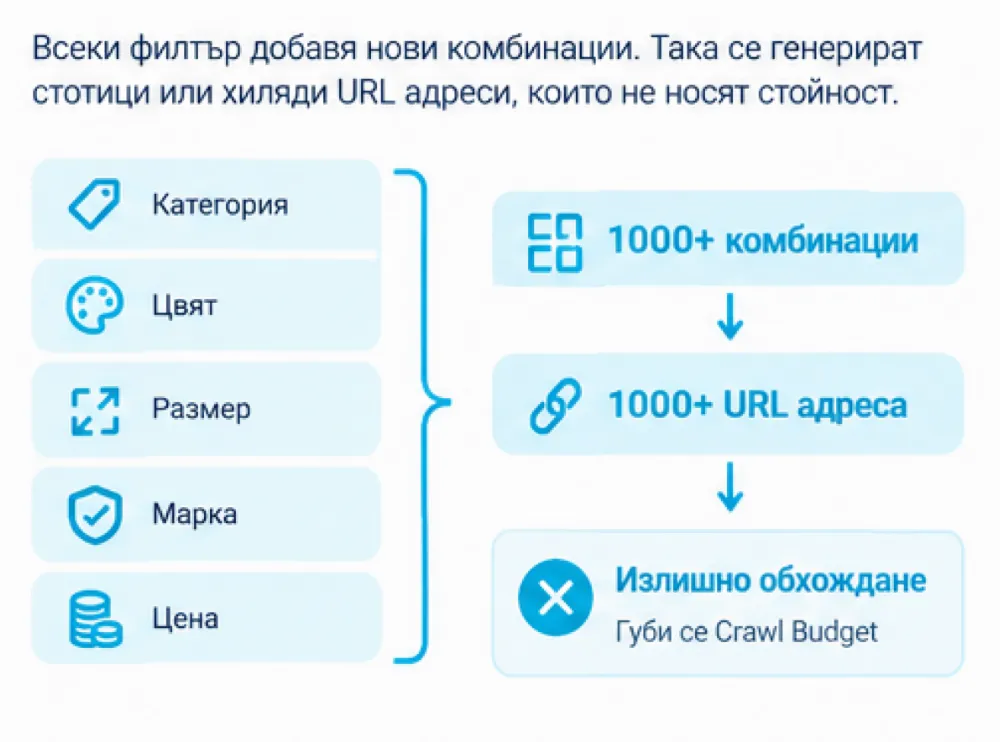
Механизмът е следният: всяка комбинация от филтри създава нов адрес. Понеже адресите изглеждат нови, а роботът не може да прецени дали са полезни, преди да ги свали, той обхожда огромен брой безполезни адреси, докато системите му установят, че са безполезни. Страничният ефект е по-бавно откриване на новото съдържание.[9]
Ако не искате филтрите да се индексират, Google предлага два подхода.[9]
Правила в robots.txt, с конкретен пример:
user-agent: Googlebot
disallow: /*?*products=
disallow: /*?*color=
disallow: /*?*size=
allow: /*?products=all$
Или – и това изненадва мнозина – филтриране чрез фрагменти. Понеже Google по принцип не поддържа фрагменти при обхождане, филтър, базиран на фрагмент, няма никакво отражение върху обхождането, нито положително, нито отрицателно:[9]
Google посочва, че rel="canonical" и rel="nofollow" също са възможност, но в дългосрочен план са по-малко ефективни от горните два метода.[9]
Ако искате филтрите да се индексират, правилата са три.[9]
-
Използвайте стандартния разделител &. Запетаята, точката и запетаята и скобите се разпознават трудно като разделители, защото най-често не изпълняват такава роля
-
Ако кодирате филтрите в пътя, например /products/fish/green/tiny, логическият им ред трябва да остава винаги един и същ и не бива да съществуват дублирани филтри
-
Връщайте 404, когато комбинация от филтри не дава резултати. Същото важи при дублирани филтри, при безсмислени комбинации и при несъществуващи страници от страницирането. Не пренасочвайте към обща страница за грешка, а върнете 404 на самия адрес
5.4 Компромисът, който си струва да се направи съзнателно
|
Подход |
Пести бюджет за обхождане |
Обединява сигналите |
|---|---|---|
|
Блокиране в robots.txt |
Да |
Не |
|
rel="canonical" |
Не – роботът трябва да свали всеки дубликат, за да види тага |
Да |
|
Фрагменти |
Да |
Не се налага |
Google добавя две уточнения за robots.txt. Файлът не се използва за временно преразпределяне на бюджет, а само за блокиране на неща, които изобщо не искате обходени. И блокираните адреси остават в опашката за обхождане много по-дълго, докато 404 или 410 са силен сигнал адресът да не се обхожда повече.[5]
5.5 Идентификатори на сесия и параметри за проследяване
Google е недвусмислен: избягвайте идентификаторите на сесия в адресите и обмислете бисквитки вместо тях.[1]
Проблемът е конкретен. Ако идентификаторът се добавя като параметър, Googlebot получава нов номер при всяко посещение, а всички тези адреси съдържат едно и също.
Същото важи за параметрите за препращане и за сортиране – Google ги изброява поименно като „нерелевантни параметри", които създават голям брой адреси.[1]
Решението е саморефериращ каноничен таг към чистия адрес:
<link rel="canonical" href="https://sait.bg/blog/saveti-url-optimizatsia">
вместо
<link rel="canonical" href="https://sait.bg/blog/saveti-url-optimizatsia?sid=235984855ghtfs">
5.6 Безкрайни пространства от адреси
Google посочва два класически източника.[1]
Календари. Динамично генериран календар може да създава връзки към бъдещи и минали дати без ограничение. Решението е nofollow към динамично създаваните бъдещи страници.
Счупени относителни връзки. Връзка от вида ../../category/stuff, поставена на грешна страница, може да породи безкрайни пространства, ако сървърът не връща правилен статус за несъществуващи страници. Решението е връзки спрямо корена вместо спрямо родителската папка.
5.7 Какво се случи с инструмента за параметри
Инструментът URL Parameters в Search Console беше обявен за спиране на 28 март 2022 г. и изключен на 26 април същата година.
Google посочи причината: едва около 1% от конфигурациите в инструмента са били полезни за обхождането. Останалите не са носели полза, а от собствениците на сайтове не се е изизквало никакво действие.[15]
Днес контролът върху параметрите минава през правила в robots.txt и през hreflang за езиковите варианти.[15]
6. Кирилица, транслитерация и многоезични сайтове
Тук разликата между писаното на български и документираното е най-голяма.
6.1 Езикът на страницата не се разпознава по адреса
Изречението стои в документацията за многоезични сайтове и почти не се цитира:
Google използва видимото съдържание на страницата, за да определи езика ѝ. Не използваме информация на ниво код, като атрибути lang, нито URL адреса.[8]
Следствието е директно: доводът „сложи кирилица в slug-а, за да разбере Google, че страницата е на български" няма основание. Езикът се разпознава по текста.
Google допълва: използвайте един език за съдържанието и навигацията на всяка страница и избягвайте паралелни преводи един до друг.[8
5.6 Безкрайни пространства от адреси
Google посочва два класически източника.[1]
Календари. Динамично генериран календар може да създава връзки към бъдещи и минали дати без ограничение. Решението е nofollow към динамично създаваните бъдещи страници.
Счупени относителни връзки. Връзка от вида ../../category/stuff, поставена на грешна страница, може да породи безкрайни пространства, ако сървърът не връща правилен статус за несъществуващи страници. Решението е връзки спрямо корена вместо спрямо родителската папка.
5.7 Какво се случи с инструмента за параметри
Инструментът URL Parameters в Search Console беше обявен за спиране на 28 март 2022 г. и изключен на 26 април същата година.
Google посочи причината: едва около 1% от конфигурациите в инструмента са били полезни за обхождането. Останалите не са носели полза, а от собствениците на сайтове не се е изизквало никакво действие.[15]
Днес контролът върху параметрите минава през правила в robots.txt и през hreflang за езиковите варианти.[15]
6. Кирилица, транслитерация и многоезични сайтове
Тук разликата между писаното на български и документираното е най-голяма.
6.1 Езикът на страницата не се разпознава по адреса
Изречението стои в документацията за многоезични сайтове и почти не се цитира:
Google използва видимото съдържание на страницата, за да определи езика ѝ. Не използваме информация на ниво код, като атрибути lang, нито URL адреса.[8]
Следствието е директно: доводът „сложи кирилица в slug-а, за да разбере Google, че страницата е на български" няма основание. Езикът се разпознава по текста.
Google допълва: използвайте един език за съдържанието и навигацията на всяка страница и избягвайте паралелни преводи един до друг.[8]
6.2 Какво препоръчва Google за самите адреси
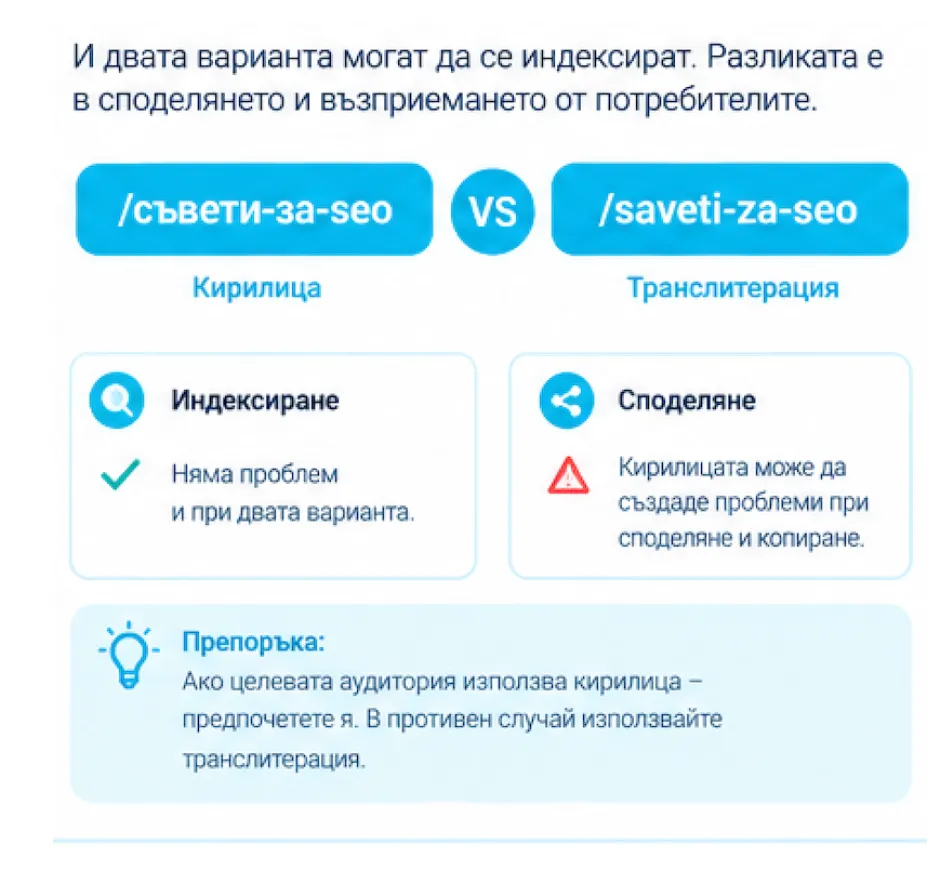
От документацията за URL структура: използвайте думи на езика на аудиторията, „и ако е приложимо, транслитерирани думи".[1]
От документацията за многоезични сайтове: локализирани думи в адреса са допустими, както и интернационализирани домейни, но задължително с кодиране UTF-8 и с правилно екраниране при поставяне на връзки.[8]
6.3 Процентното кодиране в таблицата на Google
В таблицата „Use percent encoding as necessary" кодираният вариант стои в колоната препоръчително, а нативният – в колоната непрепоръчително. Примерите включват арабски, китайски, немски с умлаут и емоджи:[1]
|
Препоръчително |
Непрепоръчително |
|---|---|
|
https://example.com/杂货/薄荷 |
|
Google дава официален пример дори с емоджи и препоръчва кодираната версия.
6.4 Какво се случва с кирилицата на практика
Кирилицата в адресите се индексира. Затруднението не е в индексирането, а в споделянето. Думата здравей в кодиран вид изглежда така:
%D0%B7%D0%B4%D1%80%D0%B0%D0%B2%D0%B5%D0%B9
Ето къде поведението се различава:
|
Среда |
Какво се случва |
|---|---|
|
Адресна лента на браузъра |
Разкодира и показва кирилицата |
|
Копиране и поставяне в чат или имейл |
Обикновено поставя кодирания низ |
|
Карти при споделяне в социалните мрежи |
Зависи от платформата |
|
Сървърни записи и аналитика |
Кодиран низ, труден за четене в отчетите |
|
Печат, диктуване по телефона, QR код |
На практика неизползваем |
6.5 Официалният български стандарт и това, което прави приставката
Тук няма източник от Google или Bing и си струва да се каже. Нормативната рамка е българска.
Законът за транслитерацията, обнародван в Държавен вестник бр. 19 от 13 март 2009 г., въвежда така наречената Обтекаема система за транслитерация на българските букви с латински.[40]
Разминаванията в практиката са три:
|
Буква |
Закон 2009 |
ISO 9 |
Типична приставка |
|---|---|---|---|
|
ж |
zh |
ž |
zh |
|
ч |
ch |
č |
ch |
|
ш |
sh |
š |
sh |
|
щ |
sht |
ŝ |
sht или sch |
|
ъ |
a |
ʺ |
u или y |
|
ю |
yu |
û |
yu или ju |
|
я |
ya |
â |
ya или ja |
Два практически извода:
-
ISO 9 не става за slug. Диакритиките изискват процентно кодиране и връщат точно затруднението, което транслитерацията би трябвало да реши
-
Проверете какво прави вашата приставка с буквата „ъ". Много инструменти прилагат руски правила върху български текст и дават u или y вместо a. Изберете едно поведение и го запишете като вътрешен стандарт на проекта, преди да сте публикували хиляди адреса
6.6 Структура за многоезични сайтове
Google дава пълна таблица с предимствата и недостатъците.[8]
|
Структура |
Предимства |
Недостатъци |
|---|---|---|
|
Национален домейн example.de |
Ясно геотаргетиране. Локацията на сървъра няма значение. Лесно разделяне на сайтовете |
Скъпо и с ограничена наличност. Изисква повече инфраструктура. Понякога строги изисквания. Таргетира само една държава |
|
Поддомейн de.example.com |
Лесно за настройка. Позволява различни локации на сървъра. Лесно разделяне |
Потребителите може да не разпознаят геотаргетирането само по адреса. Не е ясно „de" език ли е или държава |
|
Поддиректория example.com/de/ |
Лесно за настройка. Ниска поддръжка, същият хост |
Потребителите може да не разпознаят геотаргетирането. Една локация на сървъра. По-трудно разделяне |
|
Параметър site.com?loc=de |
Не се препоръчва |
Трудно сегментиране по адрес. Потребителите не разпознават геотаргетирането |
Тук се връща фактът от първата глава: поддомейнът е отделен хост и следователно има отделен бюджет за обхождане.[5] При голям сайт това е практически довод в полза на поддиректорията.
6.7 Какво Google пренебрегва и как обхожда
-
Пренебрегва локационните мета тагове като geo.position и distribution, както и геотаргетиращите HTML атрибути[8]
-
Googlebot обхожда предимно от САЩ и не изпраща Accept-Language в заявките. Ако сменяте съдържанието динамично според езиковата настройка, Google може да не открие всички варианти[8]
-
Не пренасочвайте автоматично потребителите между езиковите версии. Това пречи и на потребителите, и на търсачките да видят всички версии[8]
-
Анализът по IP адрес не е надежден метод за адаптиране на съдържанието[8]
6.8 Кои домейни Google приема за общи
Полезно за проекти с модерни разширения. Google третира като общи домейни (gTLD):[8]
-
Регионалните .eu и .asia
-
Част от националните домейни, които на практика се използват като общи: .io, .co, .me, .tv, .fm, .la, .cc, .ai, .ws и други
Тоест .io домейнът няма да ви таргетира към Британската територия в Индийския океан. Практическото значение: ако използвате такова разширение и таргетирате конкретна държава, задайте таргетирането изрично чрез hreflang.[8][22]
6.9 Hreflang и канонизацията се съгласуват
Когато предлагате сходно или дублирано съдържание на един и същ език на различни адреси – например example.de/ и example.com/de/ – изберете предпочитана версия и използвайте rel="canonical" и hreflang заедно.[8]
Bing добавя съществено уточнение: истинската локализация изисква смислени разлики – терминология, примери, регулации, продуктови детайли. Регионални страници, които се различават само по шаблонния текст, се третират като дубликати.[10]
7. Как изглеждат адресите в резултатите днес
Тук има промяна, която прави остарели доста материали, включително по-ранни наши.
7.1 Хронология
Април 2015 г. Google заменя видимия адрес на мобилни устройства с името на сайта и навигационна пътека.
23 януари 2025 г. Google премахва навигационната пътека от мобилните резултати. Обявлението е на Caitlin Dorsey, продуктов мениджър в Google Search:[12]
-
На компютър видимият адрес продължава да има две части – домейн и навигационна пътека
-
На мобилно устройство видимият адрес се свежда само до домейна
-
Промяната важи за всички езици и региони
-
Ако използвате разметка за навигационна пътека, не се налага да правите нищо. Google продължава да я поддържа за резултатите на компютър
-
Отчетът за навигационната пътека в Search Console продължава да работи, а разметката се проверява с Rich Results Test
Причината, посочена от Google: елементът не е бил особено полезен при търсене от мобилно устройство, защото се е отрязвал на малки екрани.[12]
7.2 Какво следва оттук
Доводът, че ключовите думи в адреса вдигат честотата на кликване, защото се виждат в резултатите, вече не работи на мобилно. Там се вижда само домейнът.[12]
Това не прави разметката излишна. Тя остава активна за компютър и Google изрично препоръчва да не се маха.[12][25]
Стойността на четимия адрес остава там, където винаги е била – при споделянето. Когато поставите връзка във форум, съобщение или публикация, човекът отсреща вижда целия адрес, преди да кликне.
8. Адресите и генеративното търсене
През май 2026 г. Google публикува официално ръководство за оптимизация за генеративните функции.[11][32] То дава рамката, която липсва в повечето материали по темата.
8.1 Позицията на Google
От гледна точка на Google Search оптимизацията за генеративно търсене е оптимизация за търсенето, тоест пак SEO.[11]
Причината е техническа: генеративните функции стъпват върху основните системи за класиране и оценка на качеството в Search.[11]
8.2 Условието за допустимост
Ето и частта, която засяга адресите пряко:
За да е допустима за показване в генеративните функции на Google Search, страницата трябва да е индексирана и допустима за показване в Google Search с описание, покривайки техническите изисквания на Search.[11]
Тоест всичко от глави 2, 4 и 5 е предпоставка. Ясната техническа структура е изрично посочена като една от основите. Начинът, по който Google открива и обработва страниците, „остава ядрото на това как AI системите ни достигат до данните ви".[11]
В същата глава Google включва и намаляването на дублираното съдържание сред техническите препоръки за генеративното търсене.[11]
8.3 Какво казва Bing
Указанията на Bing вече описват изрично, че покриват начина, по който Bing открива, обхожда, индексира, оценява и показва съдържание в Bing, в Copilot и в резултатите от grounding интерфейса. Неспазването им може да намали допустимостта за grounding.[27]
8.4 Механизмът, който засяга адресите пряко
Ето и най-полезното изречение по темата, което сме срещали в официален източник. То идва от Bing:
Езиковите модели групират близките дубликати в една група и после избират една страница, която да представлява целия набор. Ако разликите между страниците са минимални, моделът може да избере версия, която е остаряла или не е тази, която сте искали да изведете.[10]
Bing добавя и че дублирането забавя появата на обновленията в AI отговорите, защото роботите се връщат на дубликати вместо на обновените страници.[10]
Изводът е практичен. За видимост в AI отговорите хигиената на адресите не е нова дисциплина. Тя е същата дисциплина, но цената на грешката е по-висока. Ясният каноничен адрес означава ясен избор на представител в групата.
9. Какво позволява вашата платформа
Преди да планирате структура, вижте какво изобщо може системата ви. Тази глава стъпва върху документацията на самите платформи, а не върху Google и Bing.
9.1. WordPress
По подразбиране. Структурата на постоянните връзки се настройва от Settings → Permalinks. Наличните варианти включват дата и име, месец и име, числов, име на публикацията и собствена структура.[34]
Как се обработва slug-ът. Функцията sanitize_title() превръща заглавието в slug. В контекст „save" тя минава през remove_accents(), заменя интервалите с тирета и премахва символите извън разрешения набор.[33]
Какво не може по подразбиране. WordPress няма вградена транслитерация за кирилица. Буквите се запазват и се кодират процентно, освен ако не добавите приставка. Тук се връща глава 6.5 – проверете как приставката обработва „ъ".
Къде се получават изненади. Смяната на структурата на постоянните връзки при работещ сайт променя адресите на всички публикации наведнъж. Това е миграция и минава по глава 10.
9.2. Shopify
Какво не може да се промени. Началните сегменти на пътя са фиксирани. Всеки магазин използва /products/, /collections/, /pages/ и /blogs/. Те не могат да се махнат или преименуват.[37]
Какво може. Последната част от адреса, така нареченият handle, се редактира.
Къде се получават изненади. Продукт, достъпен през колекция, дава вложен път /collections/mens/products/shoe, докато директният достъп дава /products/shoe. Каноничният таг сочи към втория, но вътрешните връзки често сочат към първия. Резултатът е излишно обхождане. Решението е промяна в темата, така че вътрешните връзки да водят направо към каноничния адрес.
9.3. OpenCart, PrestaShop, Magento
Трите системи имат общо: адресите се пазят в база данни и се обслужват през таблица за пренаписване.
-
OpenCart. Настройката е „Use SEO URLs", изисква правила в .htaccess, а slug-овете се пазят в отделна таблица. Няма вградена защита срещу еднакви slug-ове за различни типове обекти
-
PrestaShop. Има настройка „Friendly URL", но структурата на маршрута обикновено включва числов идентификатор. Премахването му изисква намеса извън ядрото
-
Magento и Adobe Commerce. Таблицата за пренаписване расте пропорционално на броя продукти, умножен по броя категории, в които участват. При голям каталог тя достига милиони редове
Едно уточнение заради прозрачността: описанията в тази подглава стъпват върху практика, а не върху цитирана документация. Проверете конкретното поведение във вашата версия, преди да планирате структура.
Next.js и headless архитектури
Next.js използва маршрутизация по файловата система. Динамичните сегменти се задават със скоби в името на файла или папката. Семантичните адреси се препоръчват и в собствената документация на фреймуърка.[38]
Поведението при наклонена черта в края се управлява от конфигурацията. Несъответствие между конфигурацията и вътрешните връзки води до автоматични постоянни пренасочвания при повечето хостинг платформи, тоест до излишен преход при всяка вътрешна връзка.
При headless архитектура каноничният адрес се решава във фронтенда, не в системата за съдържание. Тя подава съдържание и предложен slug, а фронтендът отговаря за маршрутизацията и за генерирането на каноничния таг. Ако това не е направено изрично, средите за преглед и алтернативните фронтенди могат да попаднат в индекса.
10. Промяна на URL адресите и пренасочване
Ако решите да сменяте адреси, това е главата, по която се работи. Всичко в нея идва от документацията на Google.
10.1 Първо: струва ли си?
Google описва какво да очаквате:
При всяка значителна промяна на сайта може да наблюдавате колебания в класирането, докато Google преобхожда и преиндексира сайта. Като общо правило: при сайтове със среден размер може да отнеме няколко седмици или повече, докато Google постепенно започне да показва новите адреси вместо старите. При по-големи сайтове – още повече.[6]
Съпоставете това с това, което печелите. Ключовите думи в пътя почти нямат ефект върху класирането.[2] Дължината и дълбочината също не влияят.[4]
Затова работещите адреси не си струва да се пренаписват заради естетика или заради ключова дума. Смяната има смисъл при реален проблем – дублиране, счупена структура, миграция към нова платформа, преминаване към HTTPS, смяна на домейн.
10.2 Статус кодовете
Google групира пренасочванията по това как ги тълкува индексиращият процес, а не само по номер.[7]
|
Тип |
Методи |
Как се третира |
|---|---|---|
|
Постоянно |
301, 308, незабавен meta refresh (0 сек.), HTTP refresh (0 сек.), JavaScript location, крипто пренасочване |
Googlebot следва пренасочването, а индексиращият процес приема целта за канонична |
|
Временно |
302, 303, 307, забавен meta refresh, забавен HTTP refresh |
Googlebot следва пренасочването, но целта не се приема за канонична. Тя може да бъде индексирана при наличие на други сигнали |
Три подробности, които рядко се срещат:
-
Незабавният meta refresh се тълкува като постоянно пренасочване. Забавеният – като временно[7]
-
Пренасочване чрез JavaScript се използва само когато сървърното и meta refresh не са възможни. Google рендира страниците, но рендирането може да се провали и тогава пренасочването остава невидимо[7]
-
Постоянните пренасочвания не водят до загуба на PageRank[6]
Следва редът от документацията на Google за преместване на сайт.[6]
Подготовка
-
Инвентаризирайте старите адреси. Google посочва къде да ги търсите: в картите на сайта, в сървърните записи и аналитиката за най-посещаваните адреси, в отчета за връзки в Search Console. Включете и адресите на изображения, видео, JavaScript и CSS файлове – те се местят наравно с всичко останало
-
Направете съответствие стар → нов адрес. Едно към едно, без сливане на несвързани страници
-
Обновете анотациите на новите страници. Саморефериращ rel="canonical" на всеки нов адрес и обновени hreflang анотации, ако сайтът е многоезичен
-
Сменете вътрешните връзки на новия сайт от старите към новите адреси, по съответствието
-
Запазете два списъка. Карта на сайта с новите адреси и списък със сайтовете, които сочат към старите ви адреси
Изпълнение
-
Пуснете пренасочванията. Google препоръчва сървърни постоянни пренасочвания, 301 или 308, където това е технически възможно
-
Проверете rel="canonical" и правилата robots. Уверете се, че каноничните тагове сочат новите адреси и че noindex, поставен по време на разработката, е премахнат
-
Тествайте пренасочванията. С URL Inspection за отделни адреси или със скрипт за големи количества
-
Change of Address в Search Console – само при смяна на домейн или поддомейн. Не е нужен при преминаване от HTTP към HTTPS, при смяна между www и без www на същия домейн и при смяна на пътища в рамките на същия домейн. При смяна на домейн подайте заявка за всички верифицирани варианти на стария домейн, включително поддомейните и версиите със и без www
-
Подайте новата карта на сайта в Search Console. На този етап старата може да се премахне, защото Google ще използва новата
След това
-
Обновете външните точки. Връзките от други сайтове, профилите в социалните мрежи, рекламните кампании
-
Наблюдавайте. Картите на сайта, отчета за индексиране, заявките в Search Console, сървърните записи и аналитиката
10.4 Вериги от пренасочвания
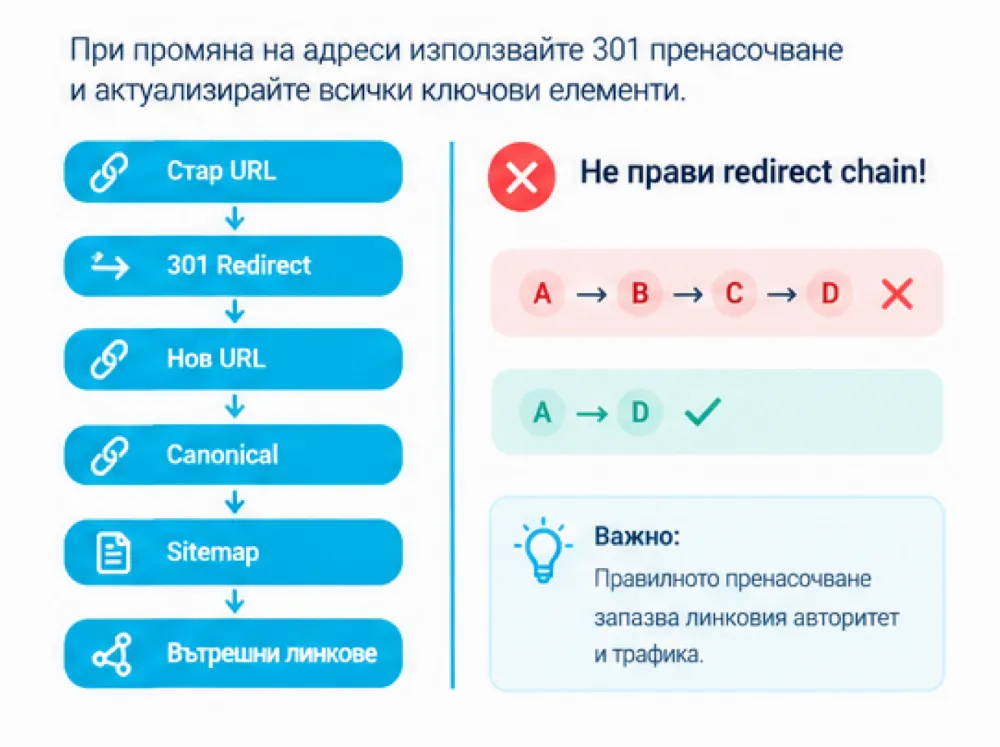
Googlebot следва до 10 прехода във верига от пренасочвания. Google въпреки това съветва пренасочване направо към крайната цел. Ако това не е възможно, дръжте броя ниско – идеално не повече от 3 и под 5.[6]
Причината не е само в SEO. Веригите добавят забавяне за потребителите, а не всички браузъри и потребителски агенти поддържат дълги вериги.[6]
10.5 Колко дълго се пазят пренасочванията
Този въпрос най-често се цитира без източник. Ето формулировката от документацията:
Пазете пренасочванията колкото е възможно по-дълго, като правило поне 1 година. Този период позволява на Google да прехвърли всички сигнали към новите адреси, включително преобхождане и преоценка на връзките от други сайтове, които сочат към старите ви адреси.[6]
И допълнението: от гледна точка на потребителите обмислете да ги запазите безсрочно. Понеже обаче пренасочванията забавят зареждането, обновявайте собствените си връзки и високотрафичните външни връзки към новите адреси.[6]
10.6 Пет грешки, които Google изброява поименно
От таблицата с чести грешки в документацията:[6]
|
Грешка |
Какво се случва |
|---|---|
|
Забравен noindex или блокиране в robots.txt от разработката |
Новият сайт не се индексира изцяло |
|
Неправилни пренасочвания |
Google често вижда пренасочвания към несъществуващи адреси на новия сайт |
|
Недостатъчен сървърен капацитет |
След миграция Google обхожда новия сайт по-интензивно от обичайното |
|
Необновени карти на сайта |
Новите адреси се откриват по-бавно |
|
Много стари адреси към една нерелевантна страница |
Може да се третира като soft 404 |
Последното заслужава внимание. Google казва изрично да не пренасочвате много стари адреси към една нерелевантна дестинация, например началната страница на новия сайт. Ако обаче сте обединили съдържание от няколко страници в една нова, пренасочването на старите към нея е правилното решение.[6]
Още едно уточнение, което спестява излишно притеснение: отчетът за карти на сайта може да покаже предупреждения за старата карта, че адресите се пренасочват. Google казва, че това е нормално и може да се пренебрегне, защото вие наистина се местите на нови адреси.[6]
10.7 Защо старият адрес продължава да се показва
Явление, което рядко се обяснява. При пренасочване Google следи и източника, и целта. Единият от двата става каноничен, а другият става алтернативно име на каноничния. Алтернативните имена са различни версии на каноничния адрес, които потребителите може да разпознават и да им се доверяват повече. Те се появяват в резултатите, когато заявката подсказва, че потребителят би се доверил на стария адрес.[7]
Google дава и конкретния случай: след смяна на домейн е много вероятно старите адреси да продължат да се появяват от време на време в резултатите, въпреки че новите вече са индексирани. Това е нормално и отшумява от само себе си, докато потребителите свикват с новото име.[7]
10.8 Какво добавя Bing
Bing препоръчва същата логика с едно допълнение:[10]
-
301 за обединяване на вариантите в един предпочитан адрес
-
Каноничен таг, когато няколко версии трябва да останат достъпни
-
Последователна структура на адресите в целия сайт
-
Блокиране на тестовите и архивните адреси от обхождане и индексиране
-
IndexNow за ускоряване. Когато обединявате страници, обновявате канонични тагове или премахвате дубликати, IndexNow уведомява участващите търсачки веднага[10][29]
11. Митовете, събрани на едно място
|
Твърдение |
Какво казва официалният източник |
|---|---|
|
Google не харесва параметри |
Обявено за мит. Параметрите се обхождат[3] |
|
Кратките адреси се класират по-добре |
Дължината не влияе на класирането. Влияе само на избора на каноничен адрес[4] |
|
Повече от три нива папки вредят |
Броят наклонени черти не влияе на класирането[4] |
|
Долните черти водят до наказание |
Наказание няма. Има разлика в разчитането и изрична препоръка старите адреси да не се преправят[1][19] |
|
Дублираното съдържание води до санкция |
Не е нарушение на правилата срещу спам[2] |
|
По-честото обхождане води до по-добро класиране |
Обхождането не е сигнал за класиране[3] |
|
noindex пести бюджет за обхождане |
Не. Google трябва да свали страницата, за да види правилото[3][5] |
|
Кирилицата в адреса помага на Google да разбере езика |
Езикът не се определя по адреса[8] |
12. Списък за проверка преди публикуване
-
Адресът покрива изискванията от глава 2, а не само препоръките;
-
Само малки букви, наложени на ниво сървър;
-
Тирета между думите, без долни черти и без слети думи;
-
Едно правило за наклонената черта в края, приложено последователно;
-
Описателни думи вместо идентификатори, доколкото платформата позволява;
-
Кирилицата е транслитерирана по един фиксиран стандарт;
-
Няма идентификатори на сесия и параметри за проследяване в каноничната версия;
-
Има саморефериращ каноничен таг;
-
Адресът в картата на сайта, в каноничния таг, във вътрешните връзки и в структурираните данни е един и същ;
-
Ако адресът заменя стар, има 301 и вътрешните връзки са обновени;
-
Няма верига от пренасочвания към този адрес;
-
Филтрите и сортирането не генерират индексируеми адреси без причина.
13. Често задавани въпроси
Google харесва ли параметри в URL адресите? Google изрично посочва като мит твърдението, че предпочита чисти адреси и не харесва параметри. Обяснението му е, че параметрите се обхождат.[3] Изискването е да използвате стандартното кодиране – знак за равенство между ключа и стойността, амперсанд между параметрите.[1]
Дължината на адреса фактор за класиране ли е? Не. John Mueller от Google казва директно, че дължината няма значение, защото адресите служат като идентификатори. Единствената ѝ роля е при канонизацията, където при избор между дубликати системите клонят към по-краткия и ясен адрес. Това не влияе на класирането, а на въпроса кой адрес се показва.[4]
Кирилица или транслитерация в адресите? Google препоръчва думи на езика на аудиторията, „и ако е приложимо, транслитерирани думи", а в таблицата си поставя кодирания вариант като препоръчителен пред нативния.[1] Практическият довод за транслитерацията е споделянето – кирилицата се разпада на дълъг кодиран низ при копиране.
Разпознава ли Google езика на страницата по адреса ѝ? Не. Google използва видимото съдържание и изрично посочва, че не използва нито атрибути lang, нито URL адреса.[8]
Колко дълго се пазят пренасочванията след смяна на адресите? Google препоръчва да се пазят колкото е възможно по-дълго, като правило поне една година. Този период позволява прехвърляне на всички сигнали, включително преоценка на връзките от други сайтове.[6]
Наклонена черта в края – да или не? Google не дава предпочитание. Важното е да изберете едно правило и да го приложите последователно, включително във вътрешните връзки и в каноничните тагове.[21]
Нужен ли ми е файл llms.txt за да обходи адресите в ИИ? За Google Search – не. Google посочва, че не използва такива файлове и че създаването им нито помага, нито вреди на видимостта.[11] Дали ги ползват други системи или биха ги ползвали в бъдеще, е отделен въпрос.
Кога бюджетът за обхождане наистина се отнася до моя сайт? При сайтове с над 1 милион страници, които се променят седмично, при сайтове с над 10 000 страници с ежедневни промени или когато голяма част от адресите ви попадат в „Discovered – currently not indexed". Ако страниците ви се обхождат в деня на публикуване, темата не е приоритет.[5]
14. Обобщение
Три неща си струва да останат.
Изискванията и препоръките са различни неща. Изискванията са три и покриването им е задължително. Препоръките надграждат, а част от тях имат по-малко значение, отколкото се твърди.[1]
Затруднението почти никога не е в думите в адреса, а в броя на адресите. Едно съдържание, един адрес, последователен навсякъде – в каноничния таг, в картата на сайта, във вътрешните връзки и в структурираните данни. Това решава повече от която и да е ключова дума в slug-а.
Ако нещо работи, оставете го да работи. Смяната на адреси носи реален риск и предвидим период на колебания.[6] Когато се налага, глава 10 описва процедурата.
И последното, което Google повтаря в почти всеки път в своите документи:
Оптимизирайте за хората!
Търсачките се справят и с несъвършените адреси, но е най-важно хората да намерят отговорите, които търсят в съдържанието, което се сервира от тези адреси.
Източници
-
Google Search Central. URL structure best practices for Google Search. Обн. 10.12.2025 г. https://developers.google.com/search/docs/crawling-indexing/url-structure
-
Google Search Central. Search Engine Optimization (SEO) Starter Guide. https://developers.google.com/search/docs/fundamentals/seo-starter-guide
-
Google Crawling Infrastructure. Myths and facts about crawling. Обн. 18.12.2025 г. https://developers.google.com/crawling/docs/myths-about-crawling
-
Google Search Central. #AskGooglebot: Does URL length matter? Отговор на John Mueller, октомври 2021 г. https://www.youtube.com/watch?v=WmEpP9aPq8o
-
Google Crawling Infrastructure. Optimize your crawl budget. Обн. 22.07.2026 г. https://developers.google.com/crawling/docs/crawl-budget
-
Google Search Central. How to move a site (Move a site with URL changes). Обн. 20.08.2026 г. https://developers.google.com/search/docs/crawling-indexing/site-move-with-url-changes
-
Google Search Central. Redirects and Google Search. Обн. 14.04.2026 г. https://developers.google.com/search/docs/crawling-indexing/301-redirects
-
Google Search Central. Managing multi-regional and multilingual sites. Обн. 10.12.2025 г. https://developers.google.com/search/docs/specialty/international/managing-multi-regional-sites
-
Google Crawling Infrastructure. Managing crawling of faceted navigation URLs. Обн. 18.12.2025 г. https://developers.google.com/crawling/docs/faceted-navigation
-
Fabrice Canel, Krishna Madhavan, Microsoft Bing. Does Duplicate Content Hurt SEO and AI Search Visibility? Bing Webmaster Blog, 19.12.2025 г. https://blogs.bing.com/webmaster/December-2025/Does-Duplicate-Content-Hurt-SEO-and-AI-Search-Visibility
-
Google Search Central. Optimizing your website for generative AI features on Google Search. Обн. 10.07.2026 г. https://developers.google.com/search/docs/fundamentals/ai-optimization-guide
-
Caitlin Dorsey, продуктов мениджър, Google Search. Simplifying the visible URL element on mobile search results. Google Search Central Blog, 23.01.2025 г. https://developers.google.com/search/blog/2025/01/simplifying-breadcrumbs
-
Google Search Central. What is URL canonicalization. https://developers.google.com/search/docs/crawling-indexing/canonicalization
-
Google Search Central. How to specify a canonical URL with rel="canonical" and other methods. https://developers.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls
-
John Mueller, Google. Spring cleaning: the URL Parameters tool. Google Search Central Blog, 28.03.2022 г. https://developers.google.com/search/blog/2022/03/url-parameters-tool-deprecated
-
Gary Illyes, Google. What Crawl Budget Means for Googlebot. Google Search Central Blog, 16.01.2017 г. https://developers.google.com/search/blog/2017/01/what-crawl-budget-means-for-googlebot
-
Google Search Central. Understand the JavaScript SEO basics. https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics
-
Google. Google developer documentation style guide: Filenames and file types. https://developers.google.com/style/filenames
-
Matt Cutts, по онова време ръководител на екипа Webspam в Google. Dashes vs. underscores, 2007 г. https://www.mattcutts.com/blog/dashes-vs-underscores/
-
John Mueller, Google. Изказване за ключовите думи в URL адресите, X, 08.03.2017 г. https://twitter.com/JohnMu/status/839527508371513344
-
John Mueller, Google. Изказване за наклонената черта в края на адреса, X, 19.12.2017 г. https://twitter.com/JohnMu/status/943198409492656128
-
Google Search Central. Tell Google about localized versions of your page. https://developers.google.com/search/docs/specialty/international/localized-versions
-
Google Search Central. Ecommerce URL structure best practices. https://developers.google.com/search/docs/specialty/ecommerce/designing-a-url-structure-for-ecommerce-sites
-
Google Search Central Blog. Deprecating our AJAX crawling scheme, 14.10.2015 г. https://developers.google.com/search/blog/2015/10/deprecating-our-ajax-crawling-scheme
-
Google Search Central. Breadcrumb structured data. https://developers.google.com/search/docs/appearance/structured-data/breadcrumb
-
Google Search Central. Visual Elements gallery. https://developers.google.com/search/docs/appearance/visual-elements-gallery
-
Microsoft Bing. Bing Webmaster Guidelines. Обн. февруари 2026 г. https://www.bing.com/webmasters/help/webmaster-guidelines-30fba23a
-
Microsoft Bing. Better than canonical: URL Normalization. Bing Webmaster Blog, април 2012 г. https://blogs.bing.com/webmaster/April-2012/Better-than-canonical;-URL-Normalization
-
Microsoft Bing. IndexNow. https://www.bing.com/indexnow
-
Google Search Central. Search Essentials: Technical requirements. https://developers.google.com/search/docs/essentials/technical
-
Google Search Central. Build and submit a sitemap. https://developers.google.com/search/docs/crawling-indexing/sitemaps/build-sitemap
-
Google Search Central Blog. A new resource for optimizing for generative AI in Google Search, 15.05.2026 г. https://developers.google.com/search/blog/2026/05/a-new-resource-for-optimizing
-
WordPress Developer Resources. sanitize_title(). https://developer.wordpress.org/reference/functions/sanitize_title/
-
WordPress. Using Permalinks. https://wordpress.org/documentation/article/customize-permalinks/
-
Joomla! Documentation. Search Engine Friendly URLs. https://docs.joomla.org/Special:MyLanguage/Search_Engine_Friendly_URLs
-
Joomla! Documentation. Enabling Search Engine Friendly (SEF) URLs on Apache. https://docs.joomla.org/Enabling_Search_Engine_Friendly_(SEF)_URLs_on_Apache
-
Shopify Community. URL structure. https://community.shopify.com/t/url-structure/402527/2
-
Next.js. SEO: URL Structure. https://nextjs.org/learn/seo/url-structure
-
Закон за транслитерацията. Обн. ДВ бр. 19 от 13 март 2009 г.

 28
 10
 10
 8
 0