
Забравете за простото броене на ключови думи. През 2026 година релевантността се оценява от генеративни AI модели и NLP алгоритми, които четат съдържанието ви почти като живи хора. Какво означава днес една страница да бъде релевантна?
Релевантността в SEO означава съвпадение между това, което потребителят търси и това, което страницата му дава. Ако отговаряте точно на намерението зад заявката и го правите бързо, лесно и качествено, страницата е релевантна. Ако не, потребителят се връща в резултатите и отваря сайта на конкурента.
Думата „релевантност“ се среща в почти всяка SEO статия и това не е случайно. Релевантността е в основата на класирането. Тя обаче не е едно нещо и през 2026 г. се оценява от машини, които работят по различен начин от преди.
Ако някога сте търсили нещо конкретно, само за да ви покажат куп несвързани резултати, знаете как се чувства потребителят: разочарован и готов да отиде другаде. Затова релевантността на търсенето е неразделна част от потребителското изживяване, а то само по себе си е фактор за класиране.
Тази статия обединява основите с актуалното за 2026 г.: какво е релевантност, трите ѝ вида, как Google я разбира чрез NLP алгоритми, как генеративните AI системи четат и цитират съдържание, как да проверите релевантността на страница и как да я повишите.
Защо релевантността е трудна
Релевантността силно зависи от контекста и от редица променящи се фактори. Типът на сайта има огромно значение: онлайн магазин и информационен сайт не се класират по един и същ начин. Различните хора изразяват търсенето си различно, а за една и съща заявка различни потребители очакват различни резултати. Затова „да си релевантен“ не е еднократна настройка, а постоянна работа по смисъла, темата и контекста.
Трите вида релевантност
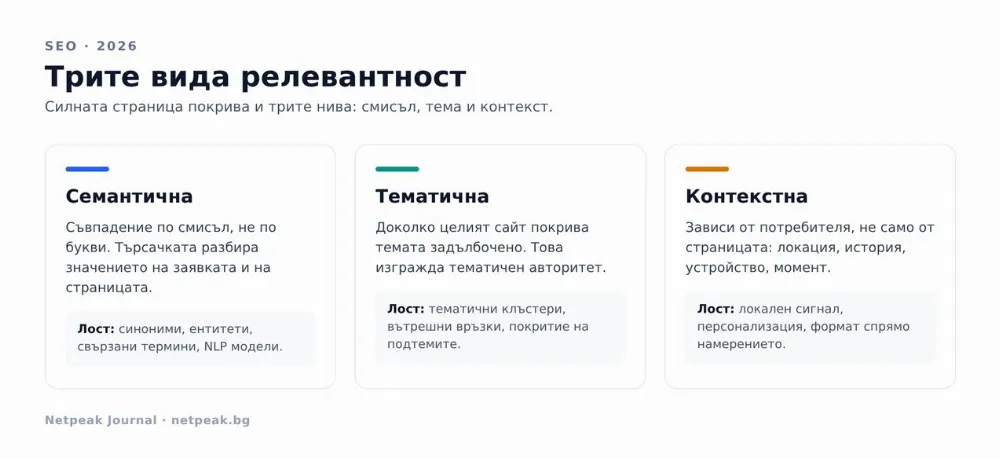
Релевантността работи на три нива. Една силна страница покрива и трите.
1. Семантична релевантност
Семантичната релевантност е съвпадение по смисъл, не по букви. Търсачката вече не брои колко пъти се среща ключовата дума. Тя разбира значението на заявката и значението на страницата, и ги сравнява.
Пример: страница за „маратонки за бягане при плоскостъпие“, която никъде не споменава формата на стъпалото, омекотяването и походката, няма да е семантично релевантна, дори да повтаря точната фраза десет пъти. Липсва смисълът, който потребителят очаква.
Семантичната релевантност стъпва на ентитети (хора, места, марки, понятия) и на връзките между тях, както и на синонимите и свързаните термини. За нея отговарят NLP моделите на Google, които разглеждаме по-долу.
2. Тематична релевантност
Тематичната релевантност показва доколко сайтът покрива цяла тема, а не една изолирана страница. Ако пишете за един предмет задълбочено и от всички страни, Google ви разпознава като източник по тази тема. Това се нарича тематичен авторитет.
Пример: магазин за кафе, който има страница за всеки метод на приготвяне, за видовете зърна, за съхранението и за настройките на мелачката, е тематично по-релевантен от магазин с една обща страница „за кафето“. Инструментът за това са тематичните клъстери, които описваме в раздела за повишаване на релевантността.
3. Контекстна релевантност
Контекстната релевантност зависи от потребителя, не само от страницата. Един и същ въпрос дава различни резултати според локацията, историята на търсене, устройството и момента. За тази релевантност говорим подробно в следващия раздел за класирането.
Класиране на релевантни страници
За често срещани заявки има хиляди, дори милиони страници с потенциално подходяща информация. Тук се намесват алгоритмите на Google, които оценяват колко полезни са те за потребителите, и класират най-добрите най-отгоре.
За да изведат най-доброто от мрежата, алгоритмите анализират стотици фактори: от актуалността на съдържанието, през начина, по който то отговаря на заявката, до това дали страницата осигурява добра работа на потребителя. Тези фактори са над 200, като всеки има различна тежест според нишата и тематиката. За да оценят надеждността и авторитета, търсачките гледат на кои сайтове потребителите се доверяват за подобни заявки.
Информация като местоположение, история на предишни търсения и настройки на браузъра помага на търсачките да персонализират резултатите. Това е контекстната релевантност на практика:
- Търсачката използва гео локацията.
Ако сте във Варна и потърсите „отворени магазини на Коледа“, първите резултати най-вероятно ще са за магазини във Варна, не в София или Пловдив. Същата заявка от София връща резултати за София.
- Търсачката използва скорошната активност, или така нареченото „персонализирано търсене“.
Ако потребителят въведе „Ливърпул“, а наскоро е търсил резултати от мачове между Ливърпул и Нюкасъл, за търсачката това е знак, че става дума за футболния клуб, не за града.
През 2026 г. контекстната релевантност се засилва с хиперперсонализацията в AI асистентите. Google свързва отговора с конкретния човек: история на търсене, свързани приложения, календар. Следствието е, че двама потребители получават различни отговори на един и същ въпрос. За измерването това значи едно: проверявайте позициите си от чист профил без история, иначе виждате своя контекст, не пазара.
Нека разгледаме няколко практически примера
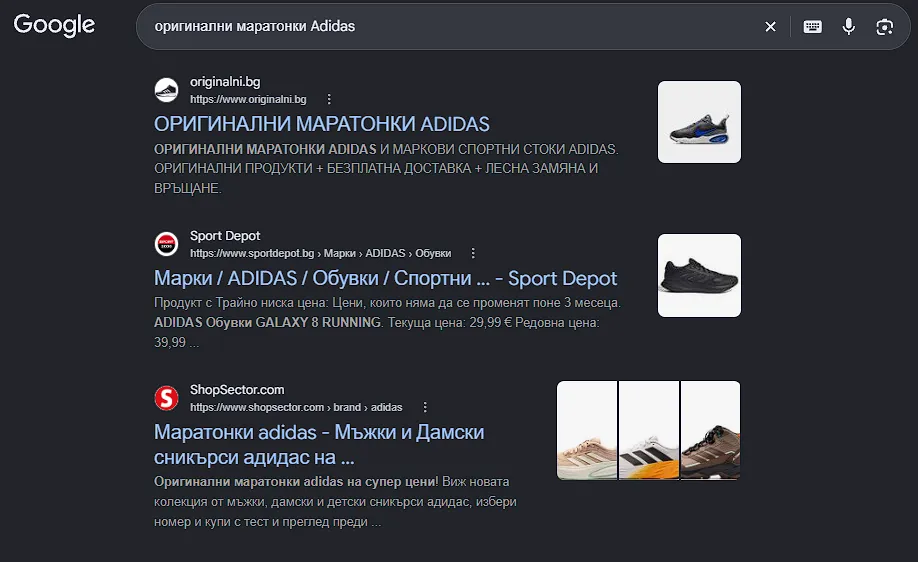
Да предположим, че търсите оригинални маратонки на марката Adidas. Логично е, след заявка „оригинални маратонки Adidas“, първите резултати да са онлайн магазини, които предлагат точно тези стоки. Виждате, че първите страници са релевантни, защото точно отговарят на заявката.
Не всички примери са толкова еднозначни. Понякога заявките са многозначни, а и самите потребители не са сигурни какво точно търсят. Тогава търсачката трябва сама да предвиди намерението и коя страница е по-релевантна.
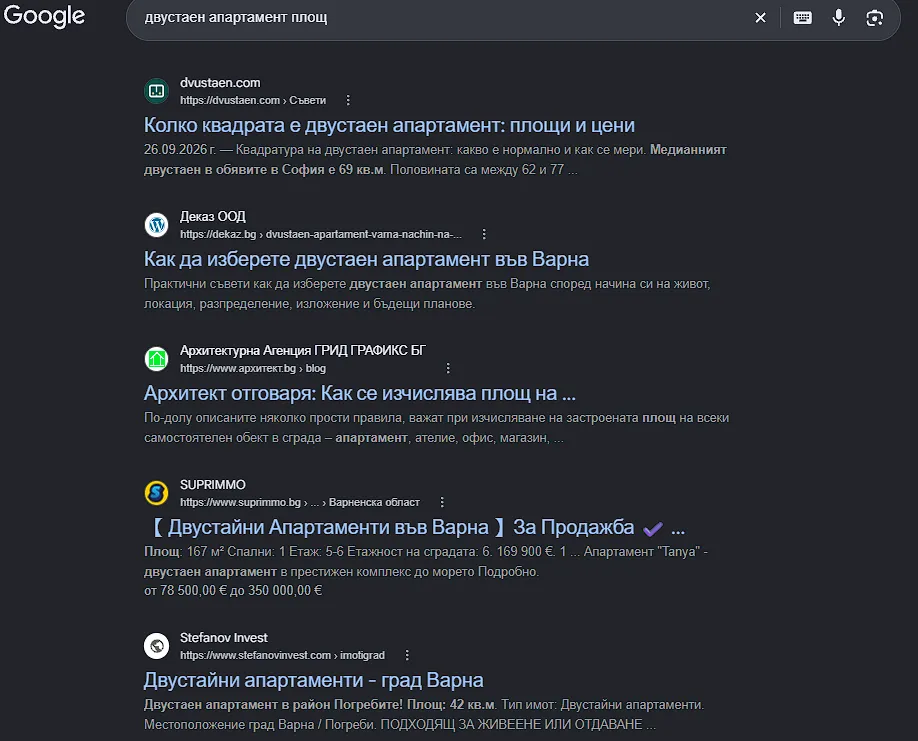
Такъв пример е „двустаен апартамент площ“: предполага се, че потребителят търси каква е площта на двустайните апартаменти, но резултатите са смес от страници за купуване на имоти, обяснения как се определя площ и видове имоти според квадратура.
Има и по-широки заявки. За „влак“ сред челните резултати виждаме разписания, статия от Wikipedia и дори детски песнички на тази тема. Google покрива няколко намерения наведнъж, защото не може да предвиди едно.
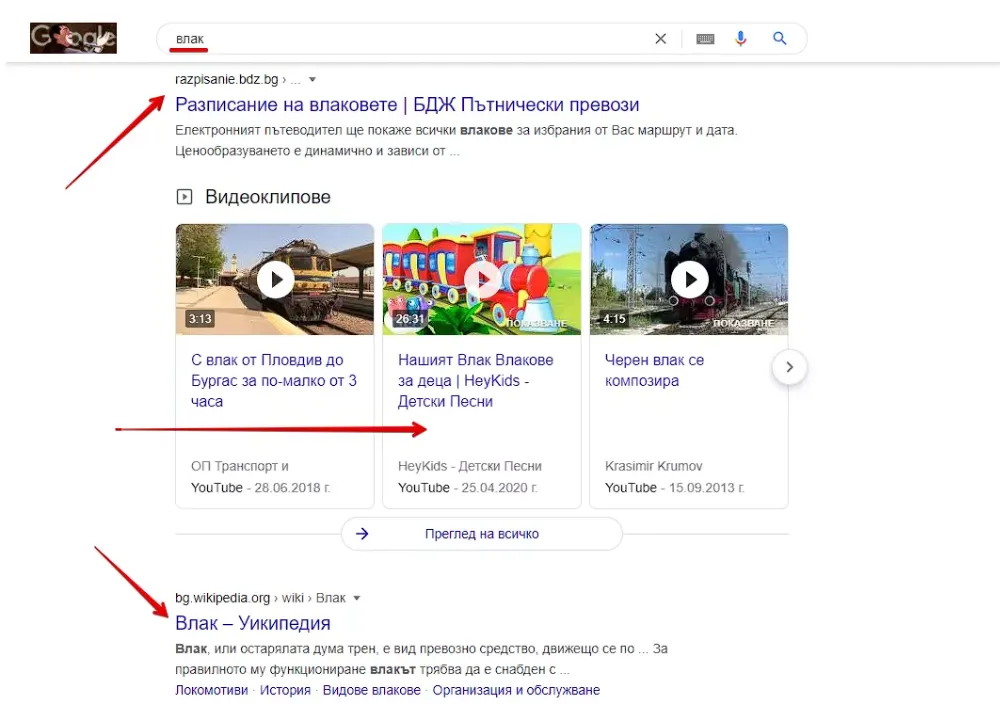
Поуката е практическа. Преди да пишете страница, вижте SERP за целевата заявка и съобразете формата с това, което Google вече класира за нея.
Как Google разбира релевантността: от ключови думи към NLP
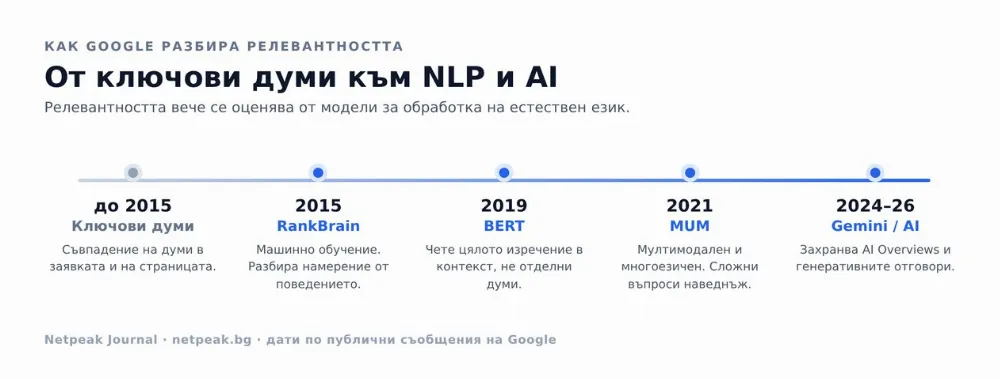
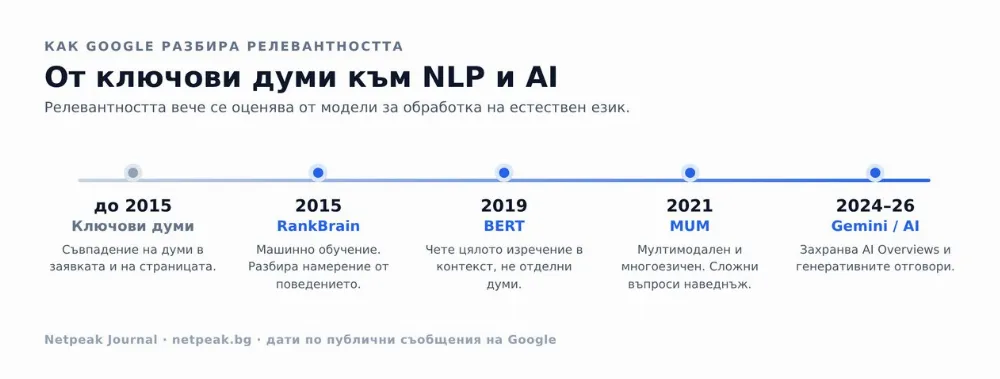
Преди 2015 г. търсачката разчиташе силно на съвпадение на ключови думи. Днес релевантността се оценява от поредица алгоритми за обработка на естествен език (NLP, Natural Language Processing). Ето основните.
RankBrain (2015)
RankBrain е първата система за машинно обучение в класирането. Тя разбира намерението зад непознати или необичайни заявки и се учи от поведението на потребителите: кликове, време на страницата, връщане в резултатите. Ако хората намират отговора си на дадена страница, RankBrain приема, че тя е релевантна.
BERT (2019)
BERT е NLP модел, който чете цялото изречение в контекст, а не отделни думи. Разбира ролята на предлозите и на словореда. Най-силен е при дълги, разговорни заявки, където значението зависи от връзката между думите. С BERT страниците се класират по смисъл, не по присъствие на ключова дума.
MUM (2021)
MUM (Multitask Unified Model) е мултимодален и многоезичен модел. Google го представи през 2021 г. с твърдението, че е около 1 000 пъти по-мощен от BERT. MUM разбира текст, изображения и други формати едновременно и отговаря на сложни въпроси с няколко намерения наведнъж. Той черпи знание на различни езици, не само на езика на заявката.
Към AI отговорите (2024 - 2026)
Същите модели днес захранват генеративните функции на Google. Моделът Gemini движи AI Overviews, а от януари 2026 г. Gemini 3 е глобалната версия по подразбиране според данни на SE Ranking. Релевантността вече не решава само кой е на първа позиция, а кой влиза в самия AI отговор.
Какво значи това за вас? Пренасищането с ключови думи не просто спря да работи. То активно вреди - потвърдено е емпирично от съвместно изследване на Princeton, Georgia Tech и IIT Delhi. Печели съдържанието, което покрива темата по смисъл.
Как LLM и AI търсачките четат съдържанието
Големите езикови модели (LLM) като ChatGPT, Perplexity и Gemini не четат страницата като човек и не я класират като класическа търсачка. Те работят по конвейер, наречен RAG (retrieval-augmented generation). Разбирането му обяснява всяка препоръка надолу.
Опростено, стъпките са:
- Потребителят задава въпрос.
- Системата разбива въпроса на няколко подзаявки.
- Извлича подходящи пасажи от уеб по смисъл, не по ключова дума.
- Подрежда пасажите по релевантност.
- Синтезира отговор и го преписва със свои думи.
- Цитира източниците според приноса им към конкретните факти.
Оптимизира се не само страница, но и пасаж. AI системата извлича отделни откъси. Всеки пасаж трябва да има смисъл сам по себе си. Извадите ли го от текста, той трябва да продължи да отговаря на въпрос. Затова избягвайте „той“, „това“, „тя“ в носещите изречения и повтаряйте името на нещото.
Колко често се появява AI отговорът
AI Overviews вече не са рядкост. Според изследване на SE Ranking около 59% от заявките показват AI Overview през февруари 2026 г., при около 28% през май 2025 г. Средно AI Overview съдържа над 15 връзки към източници (данни на SE Ranking, февруари 2026 г.). Делът варира силно по ниши и по платформи, затова всяко такова число влиза в отчет с дата, не като постоянна характеристика.
Какво кара AI системата да цитира страницата
Три техники имат най-силен потвърден ефект според академичното изследване на Princeton и партньорите:
- Цитиране на проверими източници в текста.
- Конкретни статистики вместо „значително увеличение“.
- Експертни цитати от разпознаваеми специалисти.
Към тях се добавят четимостта и форматът за извличане: директен отговор в първите едно-две изречения, една идея на параграф, изречения под 25 думи, семантичен HTML с H2 и H3, списъци и таблици. Схемата (structured data) помага за разбирането, но Google посочва, че тя не е задължителна за AI функциите.
Начини за оценка на релевантността на дадена страница
Пълната формула на Google остава частично загадка и става все по-персонализирана. Въпреки това има достатъчно начини да проверим дали дадена страница отговаря на конкретна заявка. Ето шест, от най-бързия до най-точния.
1. Ръчно в инкогнито режим
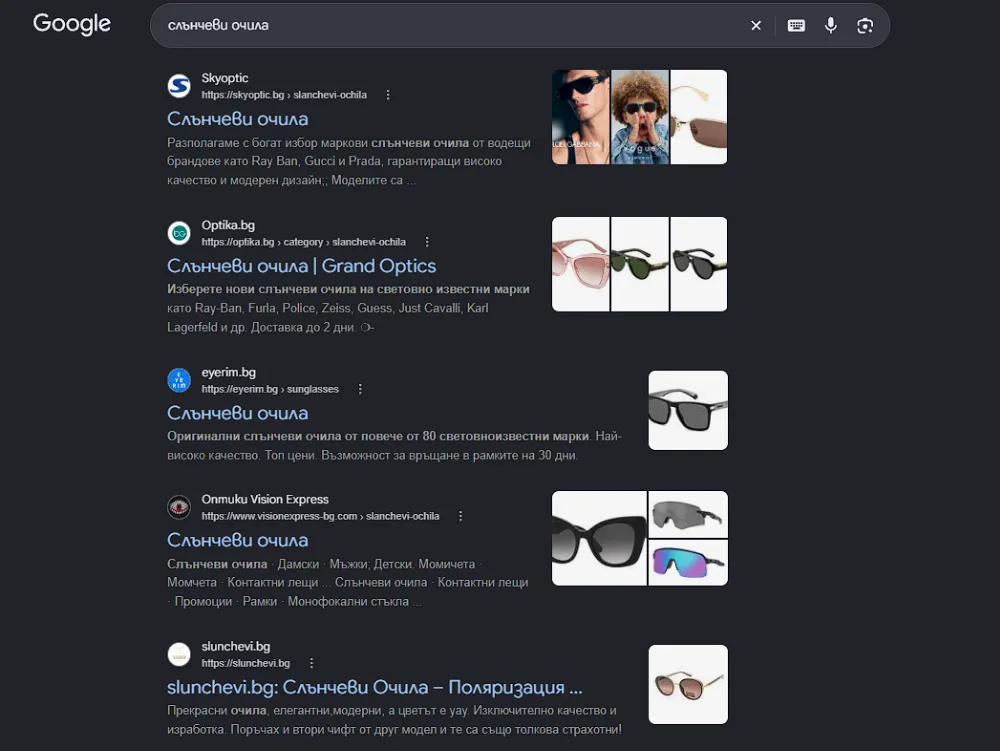
Това е най-лесният начин да проверим как се класират страниците ни спрямо конкурентите по дадена ключова дума. Влезте в режим инкогнито, за да не влияе историята на търсене, и потърсете целевата заявка. В конкретен пример за заявка „слънчеви очила“ сайтът, който ни интересува, заема 1-ва позиция.
2. Оператор site:
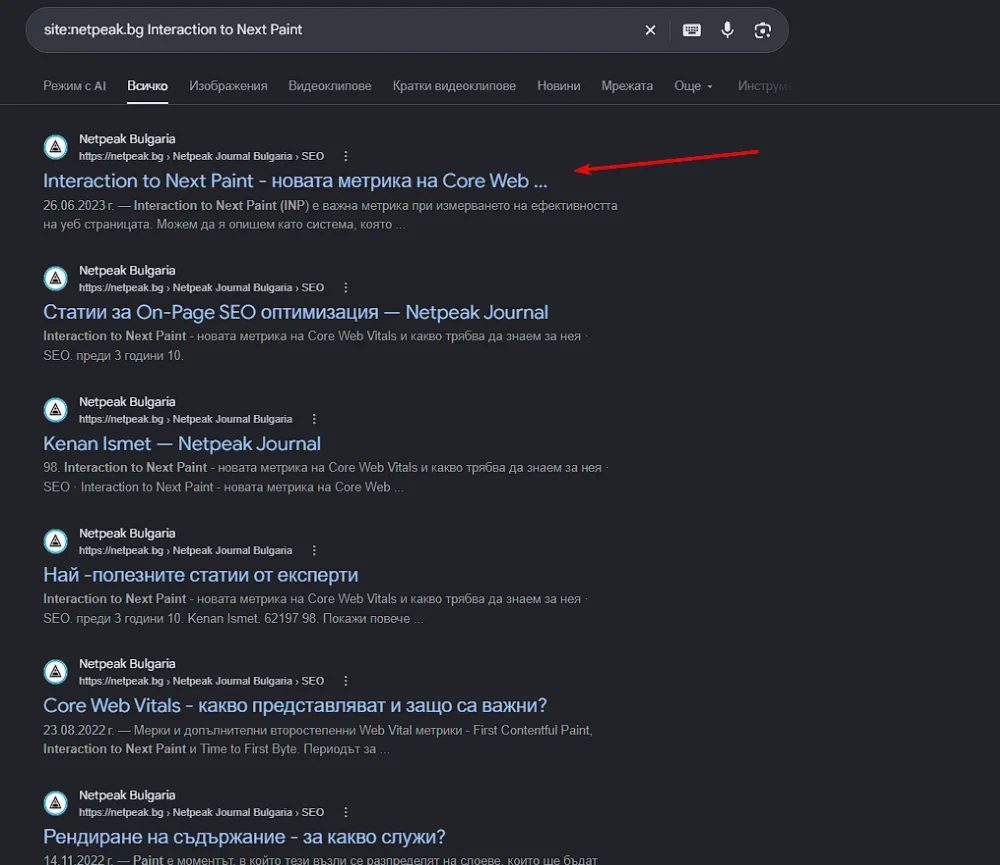
Напишете в Google site:vashiyat-sayt.bg + ключова дума. Първата страница в резултатите е тази, която Google смята за най-релевантна от вашия сайт за тази заявка. Полезно е, за да откриете дали Google класира правилната страница или бърка две ваши страници по една тема (канибализация).
В примера по-долу при “site:netpeak.bg Interaction to Next Paint” на първо място излиза нашата статия, обясняваща за метриката Interaction to Next Paint.
3. Netpeak Checker
Netpeak Checker, разработка на Netpeak, служи за масови анализи и сравнение на сайтове. Една от най-полезните му функции е проверка на класирането в SERP: получавате резултати за всякакви заявки с персонализирана геолокация, държава и езикови настройки. Изключително полезен е при голям брой ключови думи.
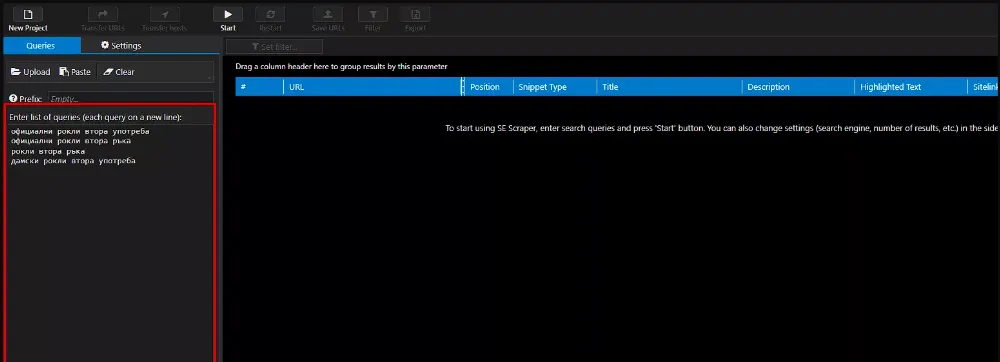
Въвеждате ключовите думи, по които искате да проверите как се класирате в SERP, в прозореца вляво. След това отваряте „Настройки“, избирате търсачката (в случая Google) и броя резултати, и слагате отметка „Search Engines“.
В полето за Google, което се показва след клик на „Search Engines“, избирате геолокация и език на резултатите.
След като натиснете „Start“, данните започват да се изтеглят.
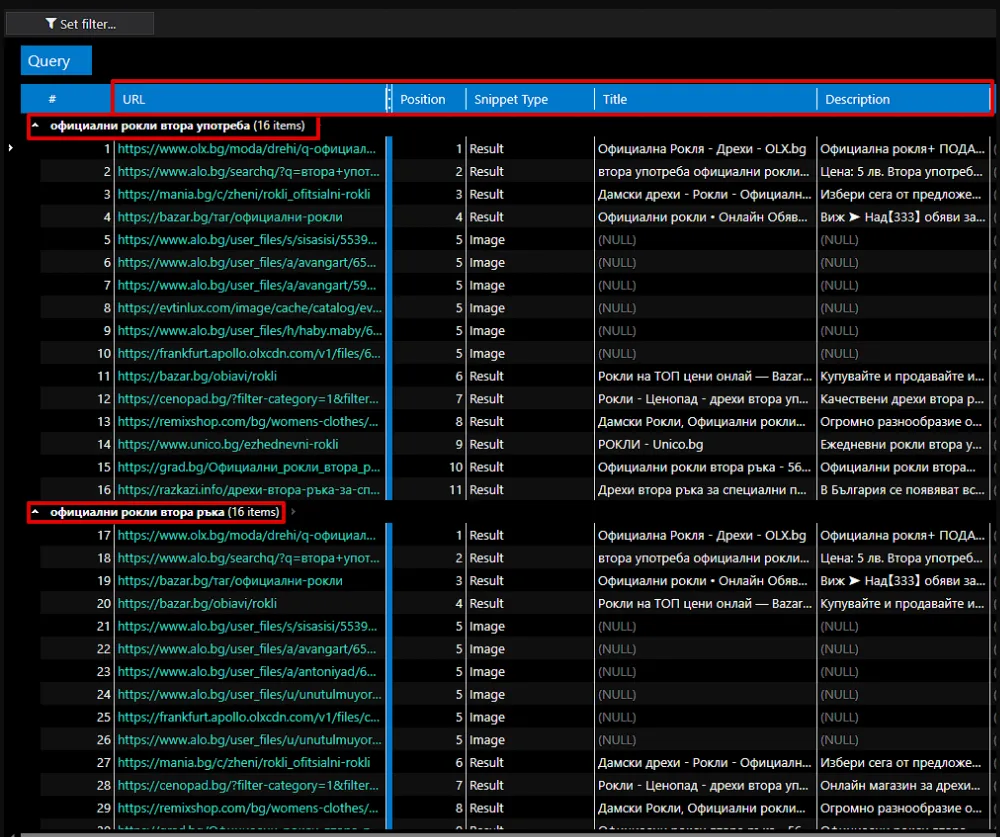
Резултатите се показват като страници, отговарящи на всяка въведена ключова дума, с URL адрес, позиция в SERP, тип снипет, както и Title и Description на релевантната страница. Визуализират се всички типове снипети.
4. Serpstat
Serpstat е платформа за дигитални маркетолози: проследяване на конкуренти, семантичен анализ, движение на ключови думи и позиции, анализ на външната линк маса и други. С функцията Rank Tracker следите класирането на вашите страници и на конкурентите в органичните резултати и получавате данни за разпределението на трафика. В отчета Keywords превключвате между домейни, региони, видове резултати и групи ключови думи в рамките на един проект.
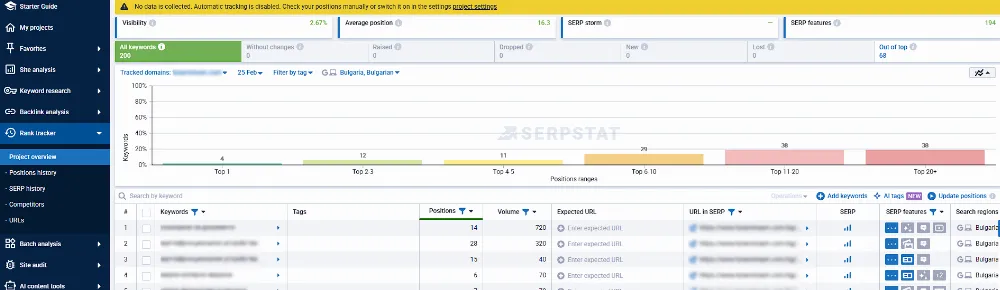
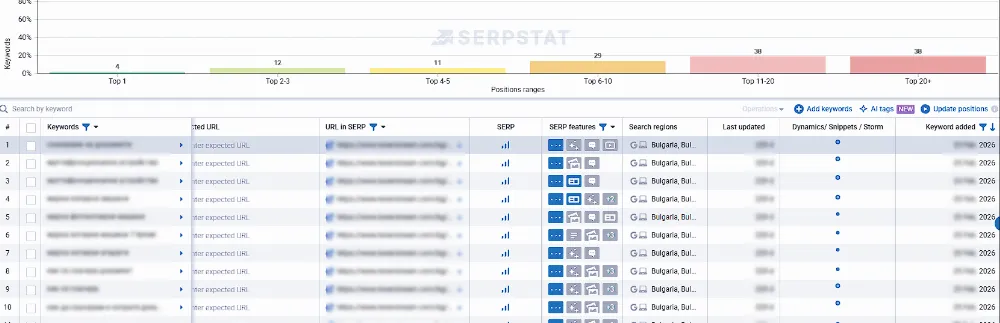
Основните параметри в отчета:
- Вид снипет в SERP - начинът, по който ключовата дума се визуализира в резултатите.
- Позиции - позицията на домейна за ключовата дума към последното актуализиране.
- Средномесечни търсения - честотата на търсене за месеца в избраната държава или град.
- Динамика на позицията - графика на промяната на позицията във времето.
- Дата на добавяне на ключовата дума.
5. Google Search Console (безплатно, реални данни)
Search Console показва реалните заявки, по които сайтът се показва и получава кликове. В отчета Performance филтрирайте по страница и вижте за кои заявки излиза тя, колко клика и импресии има, на каква средна позиция и с какъв CTR.
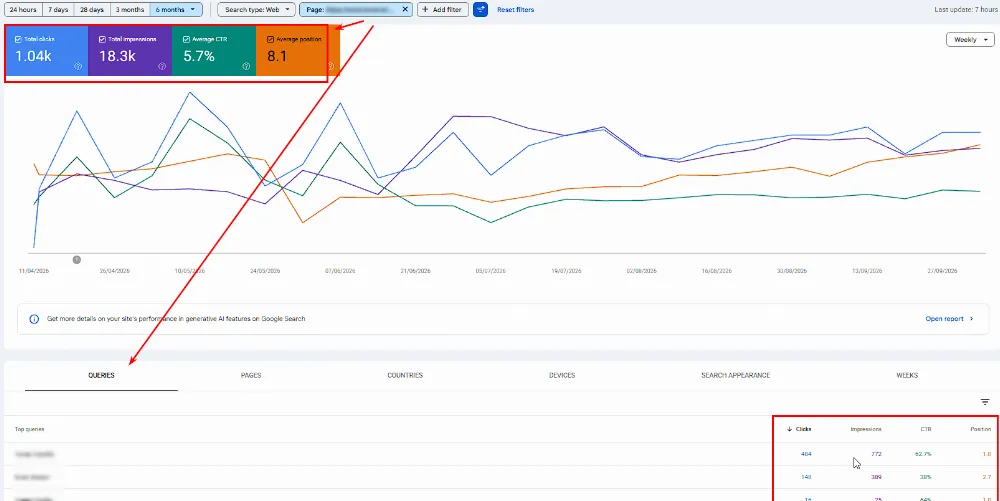
Това са реални данни за вашия сайт, не оценка. Тук може да се открие и несъответствие: страница, която излиза по заявки извън темата си, е слабо релевантна.
6. Проверка на видимостта в AI
Съставете списък от 10 до 15 реални въпроса, които клиентът ви би задал. Пуснете ги в ChatGPT, Perplexity и Gemini и запишете кои източници се цитират и дали вие присъствате. Повтаряйте със същия списък на редовен интервал. Проверявайте от чист профил, защото отговорите са персонализирани.
Как да увеличим релевантността на страниците в нашия сайт
Релевантността се гради на три нива: смисъл, тема и контекст. Стъпките по-долу покриват и трите. Част от тях са класически и остават в сила, другите са новите лостове за 2026 г.
Семантика и съдържание
1. Покрийте намерението, не само ключовата дума. След като съберете семантичното ядро и структурата на сайта, групирайте ключовите думи по общ признак и отговорете на въпроса, който потребителят реално задава. Повече в статията ни
2. Използвайте синоними и свързани термини. Синонимите разширяват темата и премахват нуждата от повтаряне на една и съща фраза. Те доказват на NLP моделите, че текстът покрива темата, а не една дума.
3. Разберете правилно LSI. LSI (latent semantic indexing) е техника от 80-те години за намиране на връзки между думи. Google почти сигурно не я използва в този вид, а John Mueller потвърди, че „LSI ключови думи“ като отделен фактор не съществуват. Полезното, което стои зад термина, е реално: семантично свързани думи, ентитети и синоними. Тях ги намирате през свързаните търсения на Google, автоматичните предложения, Wikipedia и Google Natural Language API, не през генератори на „LSI думи“.
4. Назовавайте ентитетите ясно. Пишете името на марката, продукта и автора, вместо местоимения. Това помага и на NLP моделите, и на AI системите да извлекат пасажа.
Тематичен авторитет
- Изградете тематични клъстери. Направете една основна (pillar) страница по широката тема и няколко поддържащи страници по подтемите, свързани помежду си с вътрешни връзки. Така показвате на Google, че покривате темата цялостно, и разпределяте авторитет между страниците.
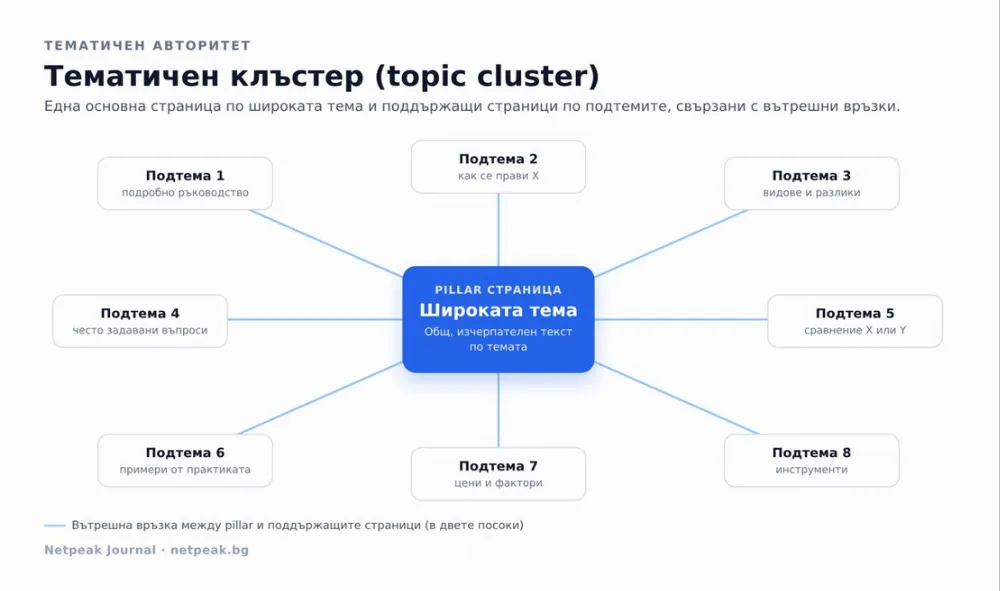
2. Налинквайте вътрешно смислено. Връзките и анкорите от други страници сочат към оптимизираната страница и обратно. Анкорът описва целевата страница, а не е общо „тук“ или „виж повече“.
3. Избягвайте канибализация. Две страници по една и съща заявка се конкурират. Обединете ги или разграничете намеренията им. Проверката е с оператора site: от предишния раздел.
Структура и техника
- Дръжте чиста структура на заглавията. Един H1, няколко H2 и H3, списъци и таблици, разделени абзаци. Включването на ключови думи в H елементите е препоръчително, но не задължително.
- Пишете мета таговете за човека и за кликването. Препоръчително е Title да започва с основната и най-високочестотна ключова дума, защото първата дума тежи най-много. Description обяснява ясно ползата и подканя към действие.
- Избягвайте пренасищане с ключови думи. Включвайте думите логично и равномерно, без спам. Пренасищането вреди, както в класическото SEO, така и в AI видимостта.
- Добавяйте поддържащо мултимедийно съдържание. Снимки, видеоклипове и други елементи, които имат отношение към темата и дават отговор на заявката на посетителя.
- Поддържайте техническото здраве. Скорост на зареждане, мобилна версия, индексируемост, основно съдържание в суровия HTML. Без това останалите стъпки нямат върху какво да стъпят.
Формат за извличане от AI
- Пишете отговора в началото. Започвайте секцията с директен отговор в едно-две изречения, после разгръщайте. Така пасажът е готов и за featured snippet, и за AI цитат.
- Правете пасажите самостоятелни. Всяко носещо изречение трябва да има смисъл извадено от контекста. Числото и единицата му са в едно изречение.
- Добавяйте конкретика и източници. Числа, дати, имена и позовавания на проверими източници вдигат шанса да бъдете цитирани.
Авторитет и Линкбилдинг
- Градете авторитет чрез линкбилдинг. Връзките от авторитетни и тематично близки сайтове повишават значимостта на страницата. Важно е донорите да са авторитетни, а текстът около връзката да е релевантен.
- Увеличавайте броя връзки постепенно. Колкото повече донори с добра репутация сочат към сайта, толкова по-голяма е значимостта му. Двата сайта трябва да са с обща тематика, а растежът да е плавен.
Заключение
Релевантността през 2026 г. не е повтаряне на ключова дума, а съвпадение по смисъл, покритие на темата и съобразяване с контекста на потребителя. Google я оценява чрез NLP модели като RankBrain, BERT и MUM, а генеративните системи извличат и цитират отделни пасажи от съдържанието ви.
Оптимизирането на релевантността е сложен и непрекъснат процес. Проверявайте по кои заявки излизат страниците ви, актуализирайте текстовете, проверявайте уникалността им, градете тематични клъстери и вътрешни връзки, и форматирайте съдържанието така, че и човек, и AI да намерят отговора си бързо. Същите стъпки, които правят текста по-полезен за читателя, го правят по-релевантен и за търсачките, и за AI.
 52
 24
 10
 18
 0